这个系列前几期一直在测本地模型”会不会”:会不会算账、会不会做 PPT、能不能跑快。这一期换个问法:如果哪天我不用 Claude 了,只用本地模型,我平时的活还能不能干完?
所以我出了 10 道题,都是我平时真的会让 AI 做的事:问问题、整理文件、写帖子、改网站、找 bug。每道题同一句话,分别交给两套组合:一边是 Claude Opus 5.5,一边是跑在我 Mac 上的 Qwen3.8-27B。
先说结论:问问题、处理文件、写东西,Qwen 和 Opus 一样能做对,只是慢 2–3 倍。改网站也能做对,但慢 3–7 倍;找 bug 时会漏掉要理解意思才看得出的问题。
两边的设置
先说清楚思考强度这件事。Opus 用的是我在 Claude Code 里的日常设置 xhigh。本地 Qwen 默认用 low,主要是为了让测试跑得快:27B 在笔记本上每秒只出几十个 token,想得越久越慢。
规则是:本地用 low 能做完的题,就不调高;做不好的题,两边都换成 high 重测。 10 道题里只有找 bug 那道 low 没做好,所以那道两边都用 high 重跑了一遍,表里放的是重跑的结果。加功能那道 Qwen 功能全对、只是超时,调高只会更慢,所以没有重测。
| 本地组 | 云端组 | |
|---|---|---|
| 外壳(harness) | DeepSeek Harness 0.2.1 桌面版,Standard 模式 | Claude Code 桌面版 |
| 模型 | Qwen3.8-27B,4-bit(oQ4e),带 MTP | Claude Opus 5.5 |
| 跑在哪 | M5 Pro 48GB,oMLX 0.7.3rc1,完全离线 | Anthropic 云端 |
| 思考强度(thinking effort) | low(找 bug 那道用 high) | xhigh(找 bug 那道用 high) |
| 权限 | Workspace Write:能读写工作目录、能跑命令 | auto:常规操作自动批准 |
| 上下文 / 单次输出上限 | 172K / 32K tokens | Claude Code 默认 |
| 生成速度 | 短 prompt 约 43 tok/s,16K 上下文约 31,64K 约 25(实测) | 没测 |
| 怎么跑 | 一题跑完再跑下一题 | 几道题同时跑 |
怎么测的
- 同一句话:每道题就是我平时会打的那句中文,两组一字不差。
- 同样的起点:网站题每次都从我网站同一个版本的独立副本开始;账本题用一个 demo 账本,里面全是虚构数据。
- 用脚本判对错,不看模型自己怎么说:凡是能用脚本判的都用脚本判。比如 Excel 逐格对账,网页功能用无头 Chrome 真的去点按钮。模型的总结写得再漂亮也不算分。
- 规则:每题限时 30 分钟,超时就算没完成。
- 样本:每题每组只跑 1 次。
结果:10 道题
| 题 | 做什么 | Qwen3.8 | 用时 | Opus 5.5 | 用时 |
|---|---|---|---|---|---|
| 咨询 | 10 道日常问题:复利、日期、代码输出、git 急救、正则、SQL、显存估算、逻辑题、HTTP、改写 | ✅ 20/20 | 2.3 分 | ✅ 20/20 | 1.2 分 |
| 记账 | 按规则把几笔开销记进对的月份(两位小数、没买的不记) | ✅ 14/14 | 2.3 分 | ✅ 14/14 | 0.4 分 |
| 写帖子 | 把一份测速结果写成英文推文和小红书 | ✅ 无事实错误 | 1.1 分 | ✅ 无事实错误 | 1.2 分 |
| 清洗 CSV | 7 种日期写法、括号负数、重复行,清成标准格式再汇总 | ✅ 12/12 | 3.8 分 | ✅ 12/12 | 1.2 分 |
| 年度 Excel | 12 个月账本做成”月 × 分类”表加趋势图 | ✅ 120 个格子全对 | 10.2 分 | ✅ 全对 | 4.3 分 |
| 10 月 PPT | 一句话做 10 月开销 PPT | ✅ 数字全对 | 11.3 分 | ✅ 数字全对,多 3 页分析 | 12.8 分 |
| 发文章 | 中文草稿发成网站上的中英两篇 | ✅ 15/15 | 12.6 分 | ✅ 15/15 | 3.9 分 |
| 修 bug | 文章页”中”按钮跳错 | ✅ 5/5 | 6.3 分 | ✅ 5/5 | 2.2 分 |
| 加功能 | Writing 页加标签筛选,中英两版、手机也要好看 | ✅ 13/13,但超时 | 37 分 | ✅ 13/13 | 5.2 分 |
| 找 bug | 网站里埋了 5 个 bug,只查不改(两边都用 high) | ⚠️ 找到 2 个 | 40 分 | ✅ 5 个全找到 | 6.6 分 |
找 bug 那道,Qwen 用 low 时找到 3 个、用了 31 分钟;换成 high 反而只找到 2 个、用了 40 分钟。
合起来看:Opus 10 道全对;Qwen 9 道做对(其中加功能那道超时),找 bug 那道只找到一部分。用时上,10 道题 Qwen 一共 127 分钟,Opus 39 分钟;按每道题的用时比取中位数,Qwen 慢 3 倍。
Qwen 做得好的
数字和规则,它是真的靠谱。 记账、清洗 CSV、年度 Excel、PPT 里的数字,全部对,没有一个算错的格子。它的习惯很稳:先把规则读透,然后写 Python 脚本算,算完回头核对。慢,但不糊弄。
它不撒谎。 10 道题里,Qwen 没有一次”说做完了其实没做完”。每次的总结都和实际文件对得上,“没 commit、没 push、草稿保留没动”这种话都说得清清楚楚。
咨询题完全够用。 10 道题全对,正则和 SQL 我实际跑过测试用例,都通过。
Qwen 吃力的地方
1. 慢,而且越复杂越慢。 简单题慢 2–3 倍还能接受。但”加一个标签筛选”这种要反复改代码、构建、验证的题,Opus 5 分钟,Qwen 37 分钟。
2. 找 bug 漏了”要理解意思”的那种,调高思考强度也没用。 我埋了 5 个 bug。坏图片、中英日期不一致,Qwen 两次都找到了;About 页标题写错,low 找到了,high 反而漏了。“文章列表从旧到新排”和”中文首页有个链接跳到英文页”这两个,两次都没发现。有意思的是,它两次都在报告里写到了”这篇排到了前面几篇中间”,却没意识到是整个列表排反了。Opus 在浏览器里把 66 个页面全扫了一遍,逐篇对比中英两版,6.6 分钟找全 5 个。
3. 子代理会放大慢。 第一次跑找 bug 时,它开了 4 个子代理并行检查。云端开子代理是真的并行,本地却只有一块 GPU,4 个子代理只能排队,跑了 1 个多小时还没完。
Opus 多做的那一点
对错上两边经常打平,差别在”多想一步”:
- 修 bug 时,它顺手在网站的检查脚本里加了一条回归检查,以后再出同样的问题会直接报错;
- 发文章时,它提醒我草稿表格里一个 “+6%” 按表里的数字算其实是 +5.4%;
- 年度 Excel 它用的是”明细表 + 公式”,改明细,汇总会自动更新;Qwen 是用脚本算好再填进去;
- 做 PPT 时,它多做了几页历史对比(11 个月均值、同期对比、月底预测),我拿账本逐个重算,全对;
- 加标签筛选时,它把手机版的标签做成一行横向滑动,第一篇文章还留在第一屏(下面有图)。
两个意外
意外一:桌面版的标签筛选两边几乎一模一样,手机版才看出差别。
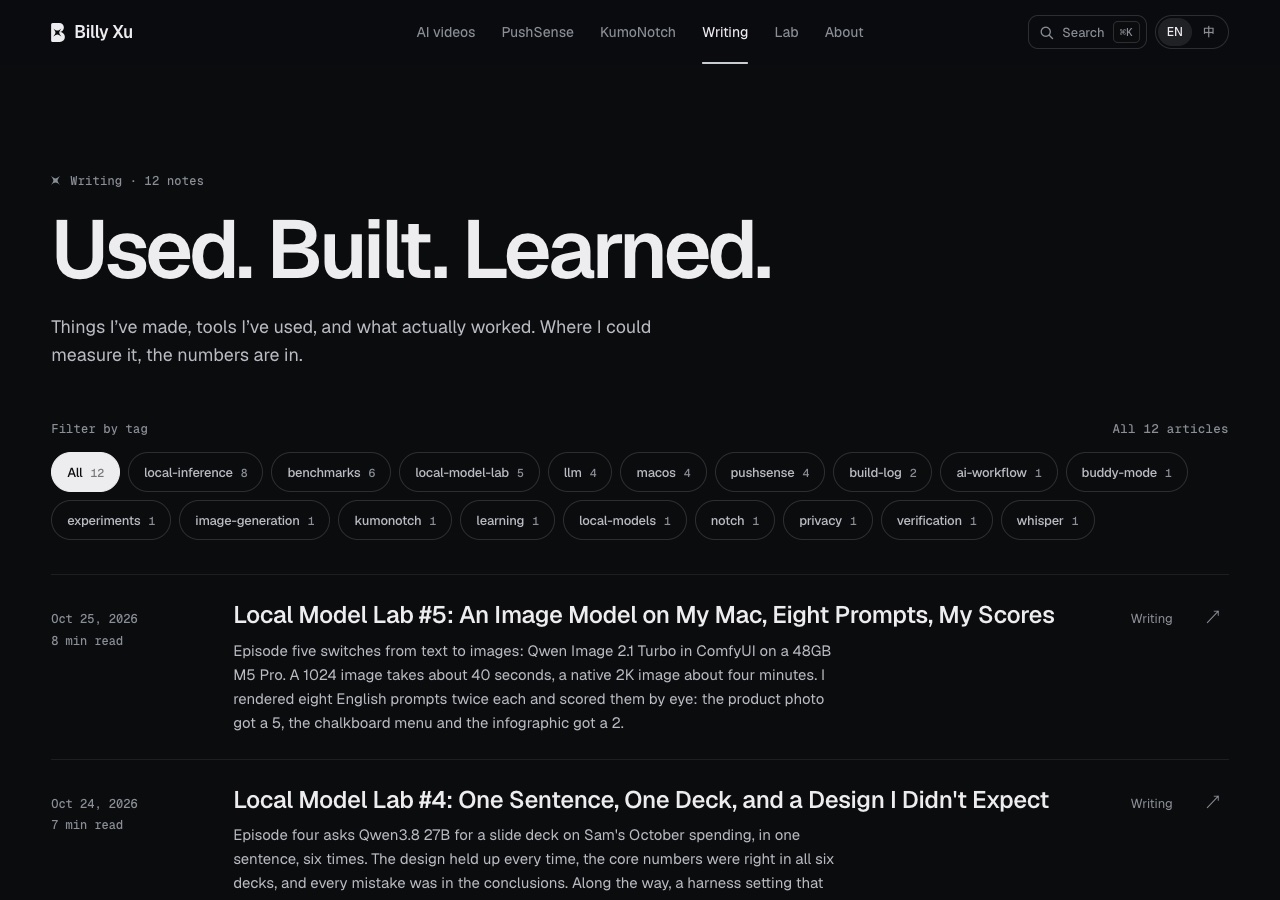
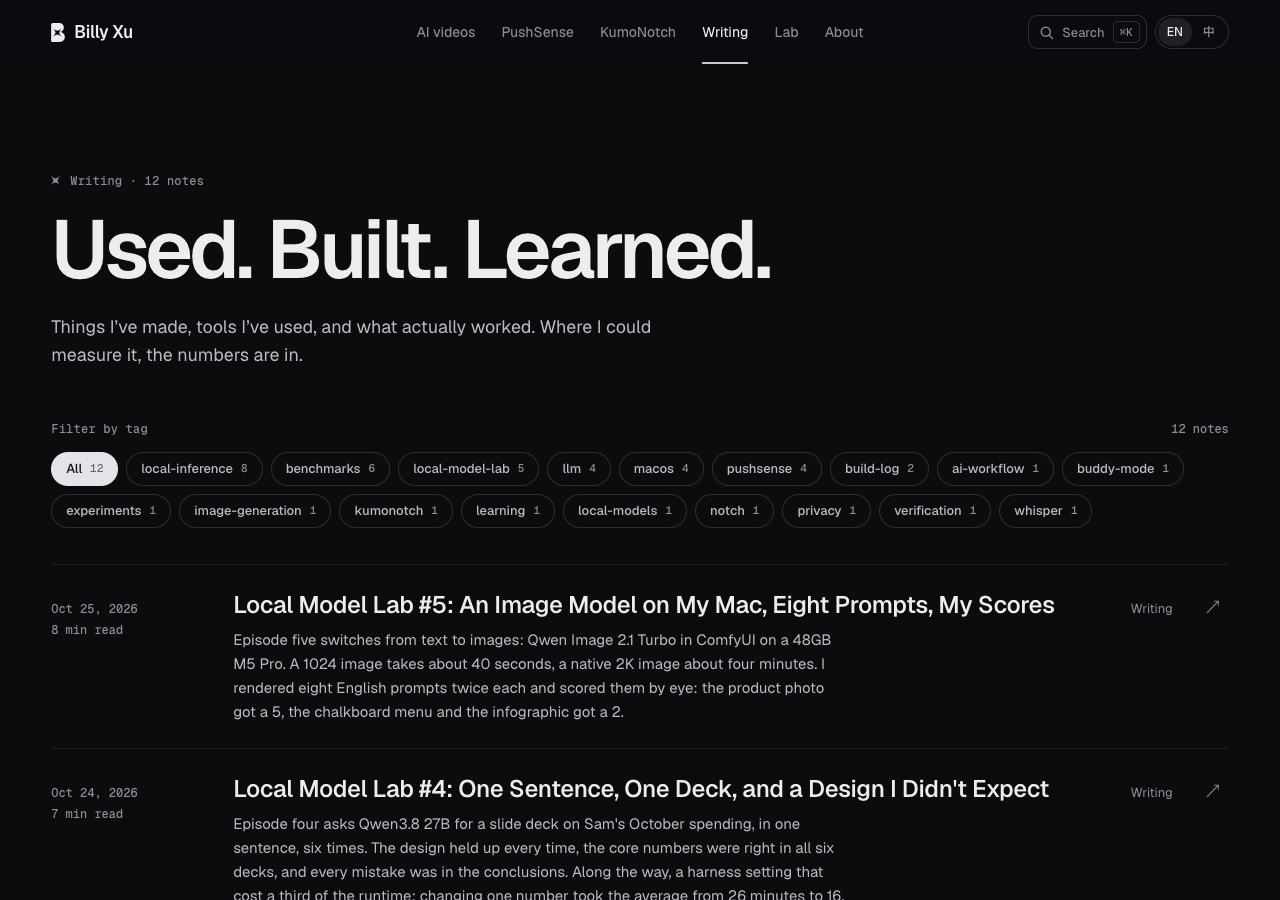
上面是 Qwen,下面是 Opus。都是”Filter by tag”、带篇数的胶囊按钮、按文章数排序。在一个已经有设计体系的网站里改东西,两个模型都会老老实实照着现有风格来。
换到手机上就不一样了:
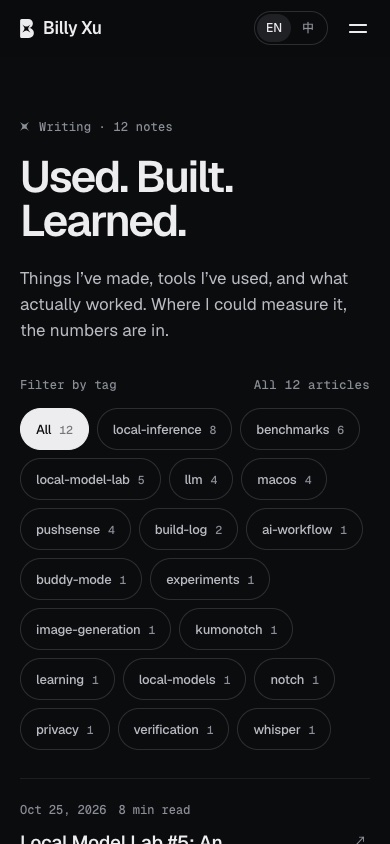
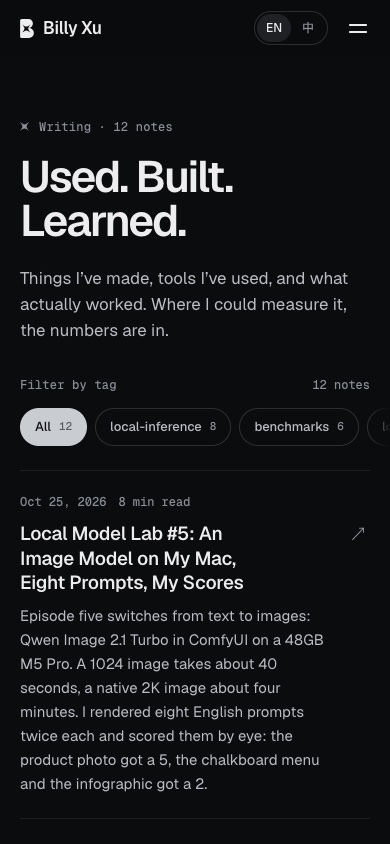
左边 Qwen 把 22 个标签全部换行铺开,手机第一屏全是标签,文章被挤到了下面;右边 Opus 把标签放进一行横向滑动,第一篇文章还在第一屏。还有个小细节:Qwen 的计数写 “All 12 articles”,Opus 写 “12 notes”,和页面顶部 “Writing · 12 notes” 的用词一致。两边的功能检查都是 13/13,这种差别脚本测不出来,要人去看。
意外二:测试顺便帮我找到了网站本来就有的问题。 找 bug 那道题,两边除了我埋的 5 个,还各自报了几个真实存在的小问题,比如中英两版 PushSense 页上的语言比例数字对不上、有一篇文章的中文标签忘了翻译。两边都没有误报。
我自己也踩了坑
为了让结果可信,有几件事要坦白:
- 题目泄露了答案。 第一次出找 bug 题时,我把埋的 bug 放在一个单独的 git 提交里,Opus 一看提交历史就知道改了哪 5 处。后来我把历史清掉,两组都重跑了。
- 答案又漏了一次。 清掉历史后,Opus 重跑还是 5 个全找到。我回头查记录才发现:Claude Code 里从同一个对话开出去的会话共用一个笔记文件夹,第一次那个会话把找到的 bug 写进了笔记,重跑时它一开头就读到了。那次结果作废。最后用 high 重测时,我把网站副本放进完全独立的文件夹,笔记清空,跑完逐条检查两边读过的每个文件、跑过的每条命令,都没有越界。表里的是这一轮的结果。
- 题库被污染过。 记账题的种子文件在一个多月前被某次测试直接写进了答案,我发现后恢复了原样,两组重跑。
- 检查脚本也会判错。 Opus 的 Excel 用的是 SUMIFS 公式,我的脚本一开始不会算,把对的判成了错;还有一次把表格底下的脚注当成了 10 月那一行。修好以后,我又故意改错几个格子,确认脚本还能抓出来。
- 断电。 有一次电脑没电,Qwen 正在跑的那道题被打断,作废重跑。
我的结论
| 我平时的活 | 能不能交给本地 Qwen |
|---|---|
| 问问题、查概念 | 能 |
| 整理文件、Excel、CSV、记账 | 能,慢 2–3 倍 |
| 写帖子、翻译、发双语文章 | 能 |
| 修小 bug、加小功能 | 能做对,但慢 3–7 倍 |
| 网站排查 | 一半,会漏需要理解意思的问题 |
如果要用本地模型干活,我会这样安排:
- 数字类、规则类、文件类的活放心交给它,它比我想象的稳;
- 赶时间的、要理解意思的排查,还是交给 Claude;
- 界面类的改动,手机上要自己看一眼,检查脚本全过不代表体验一样;
- 别让它开子代理,本地只有一块 GPU,子代理只会排队。
局限和下一步
- 每题只跑了 1 次,看不出稳定性;
- 除了找 bug 那道,两边的思考强度不同(Qwen low,Opus xhigh);
- Claude 组是几道题同时跑的,用时偏长一点;
- 上网调研、用浏览器测网站这两类这次没测:一个缺搜索服务,一个是浏览器插件我审查后决定先不装;
- 从零做一个完整网站这次也没放进来。
下一期打算:
- 我单独出一道”从零做网站”的题,资料直接写在题目里,不需要上网查——本地模型上网找资料特别花时间;
- PPT 这类要分析的题,Qwen 换 high 再试,看分析深度能追上多少;
- Qwen4 出来以后,用同一套题直接对比。