上一期我把 Qwen3.8 27B 调得又快又稳。这一期换一种活:不问问题,让它交一份能直接打开的东西。我只说了一句话:
can you make a ppt about the spending for Oct using the data in this vault?第一份出来的时候我挺惊讶的。配色、卡片、图表、每页标题里直接写结论,都很像样。我个人觉得很不错,真的有 Opus 4.6 的感觉。
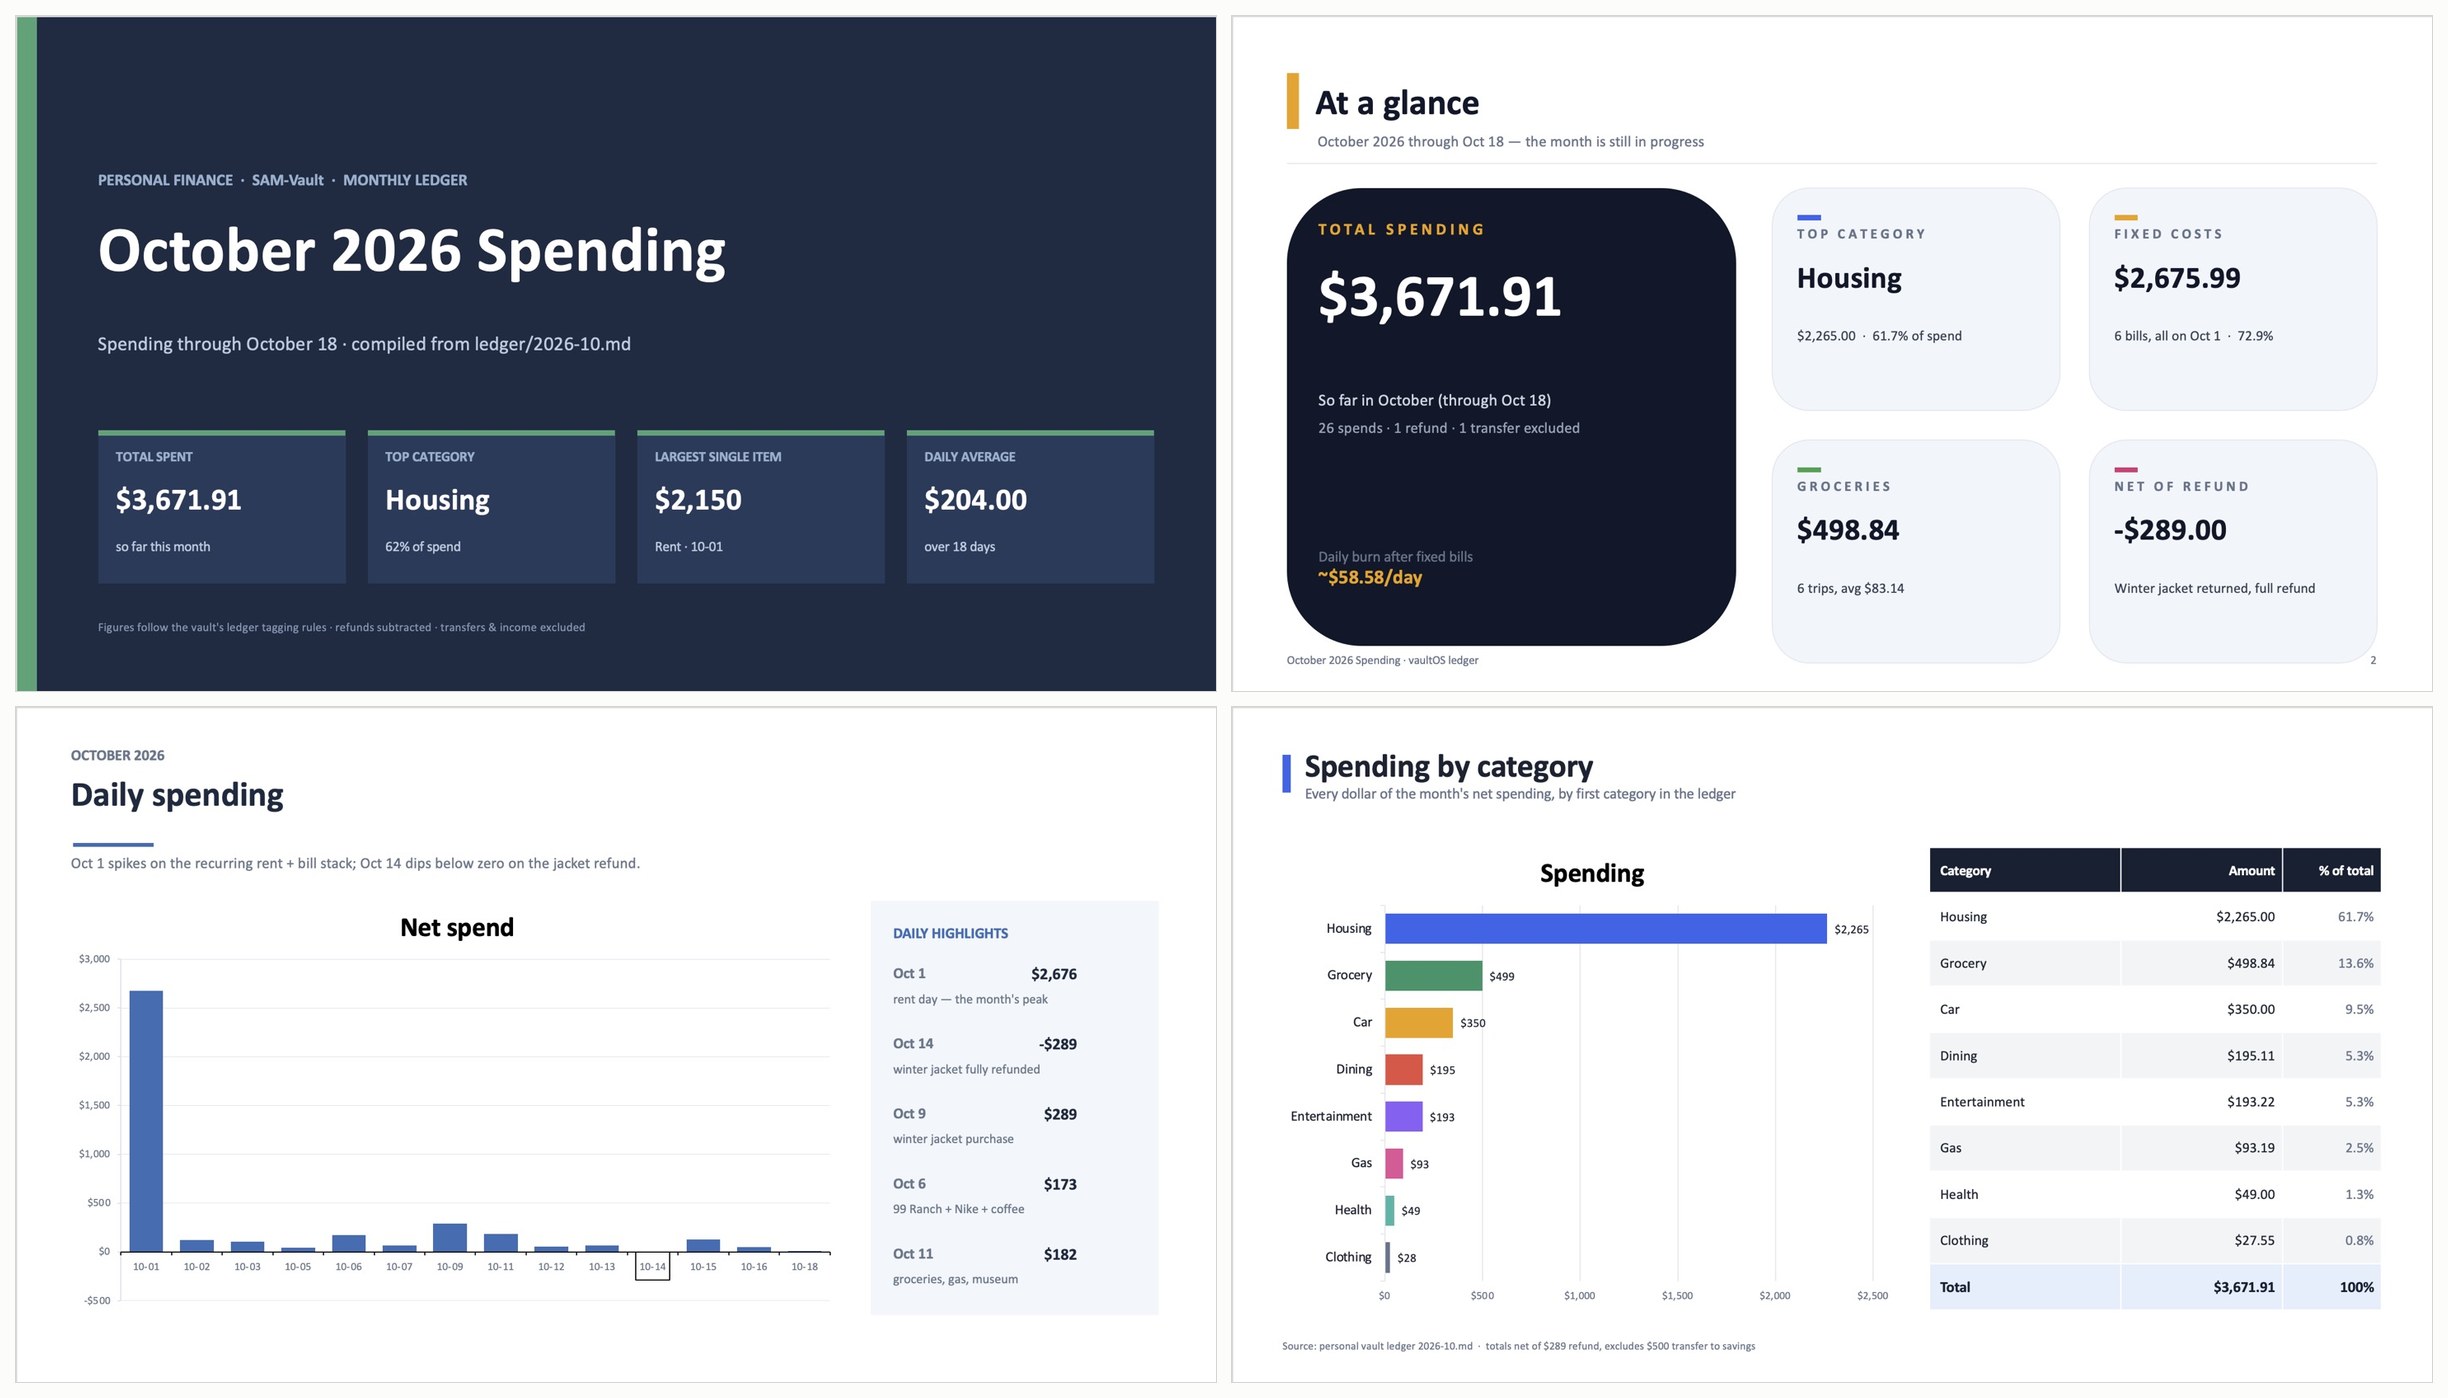
好看归好看,我还是想知道两件事:数字靠不靠谱,这个水平是不是碰巧。所以同一个 prompt 我一共跑了 6 次,每一份都在 PowerPoint 里一页页看过,每个数字都拿账本重新算了一遍。(「有 Opus 4.6 的感觉」是我的主观印象,这次没有用 Opus 跑同一个 prompt 做对照。)
实验设置
- 环境:同一台 48GB 内存的 Apple Silicon Mac(M5 Pro),DeepSeek Harness 0.2.1-rc.3,oMLX 0.7.2。模型是上一期选定的 Qwen3.8-27B-oQ4e-mtp,思考开在 low。
- 数据:还是虚构人物 Sam Lin 的笔记。10 月的账记到 18 号,一共 28 行,坑还是那几个:一笔转进储蓄的钱,一件买了又退的外套,还有一份写着记账规则的
tags.md。 - 规矩:每次一个新会话,Standard 模式,允许写文件(要生成 PPT)。prompt 一字不改,我没说文件在哪,也没提规则。每次开始前把上一次的产物移出 vault,让它看不到。
- 评分:后几次开跑之前,我先写好一份评分清单,6 份都按同一份清单打分。正确答案由脚本从账本算出。
设计:6 次,6 种样子
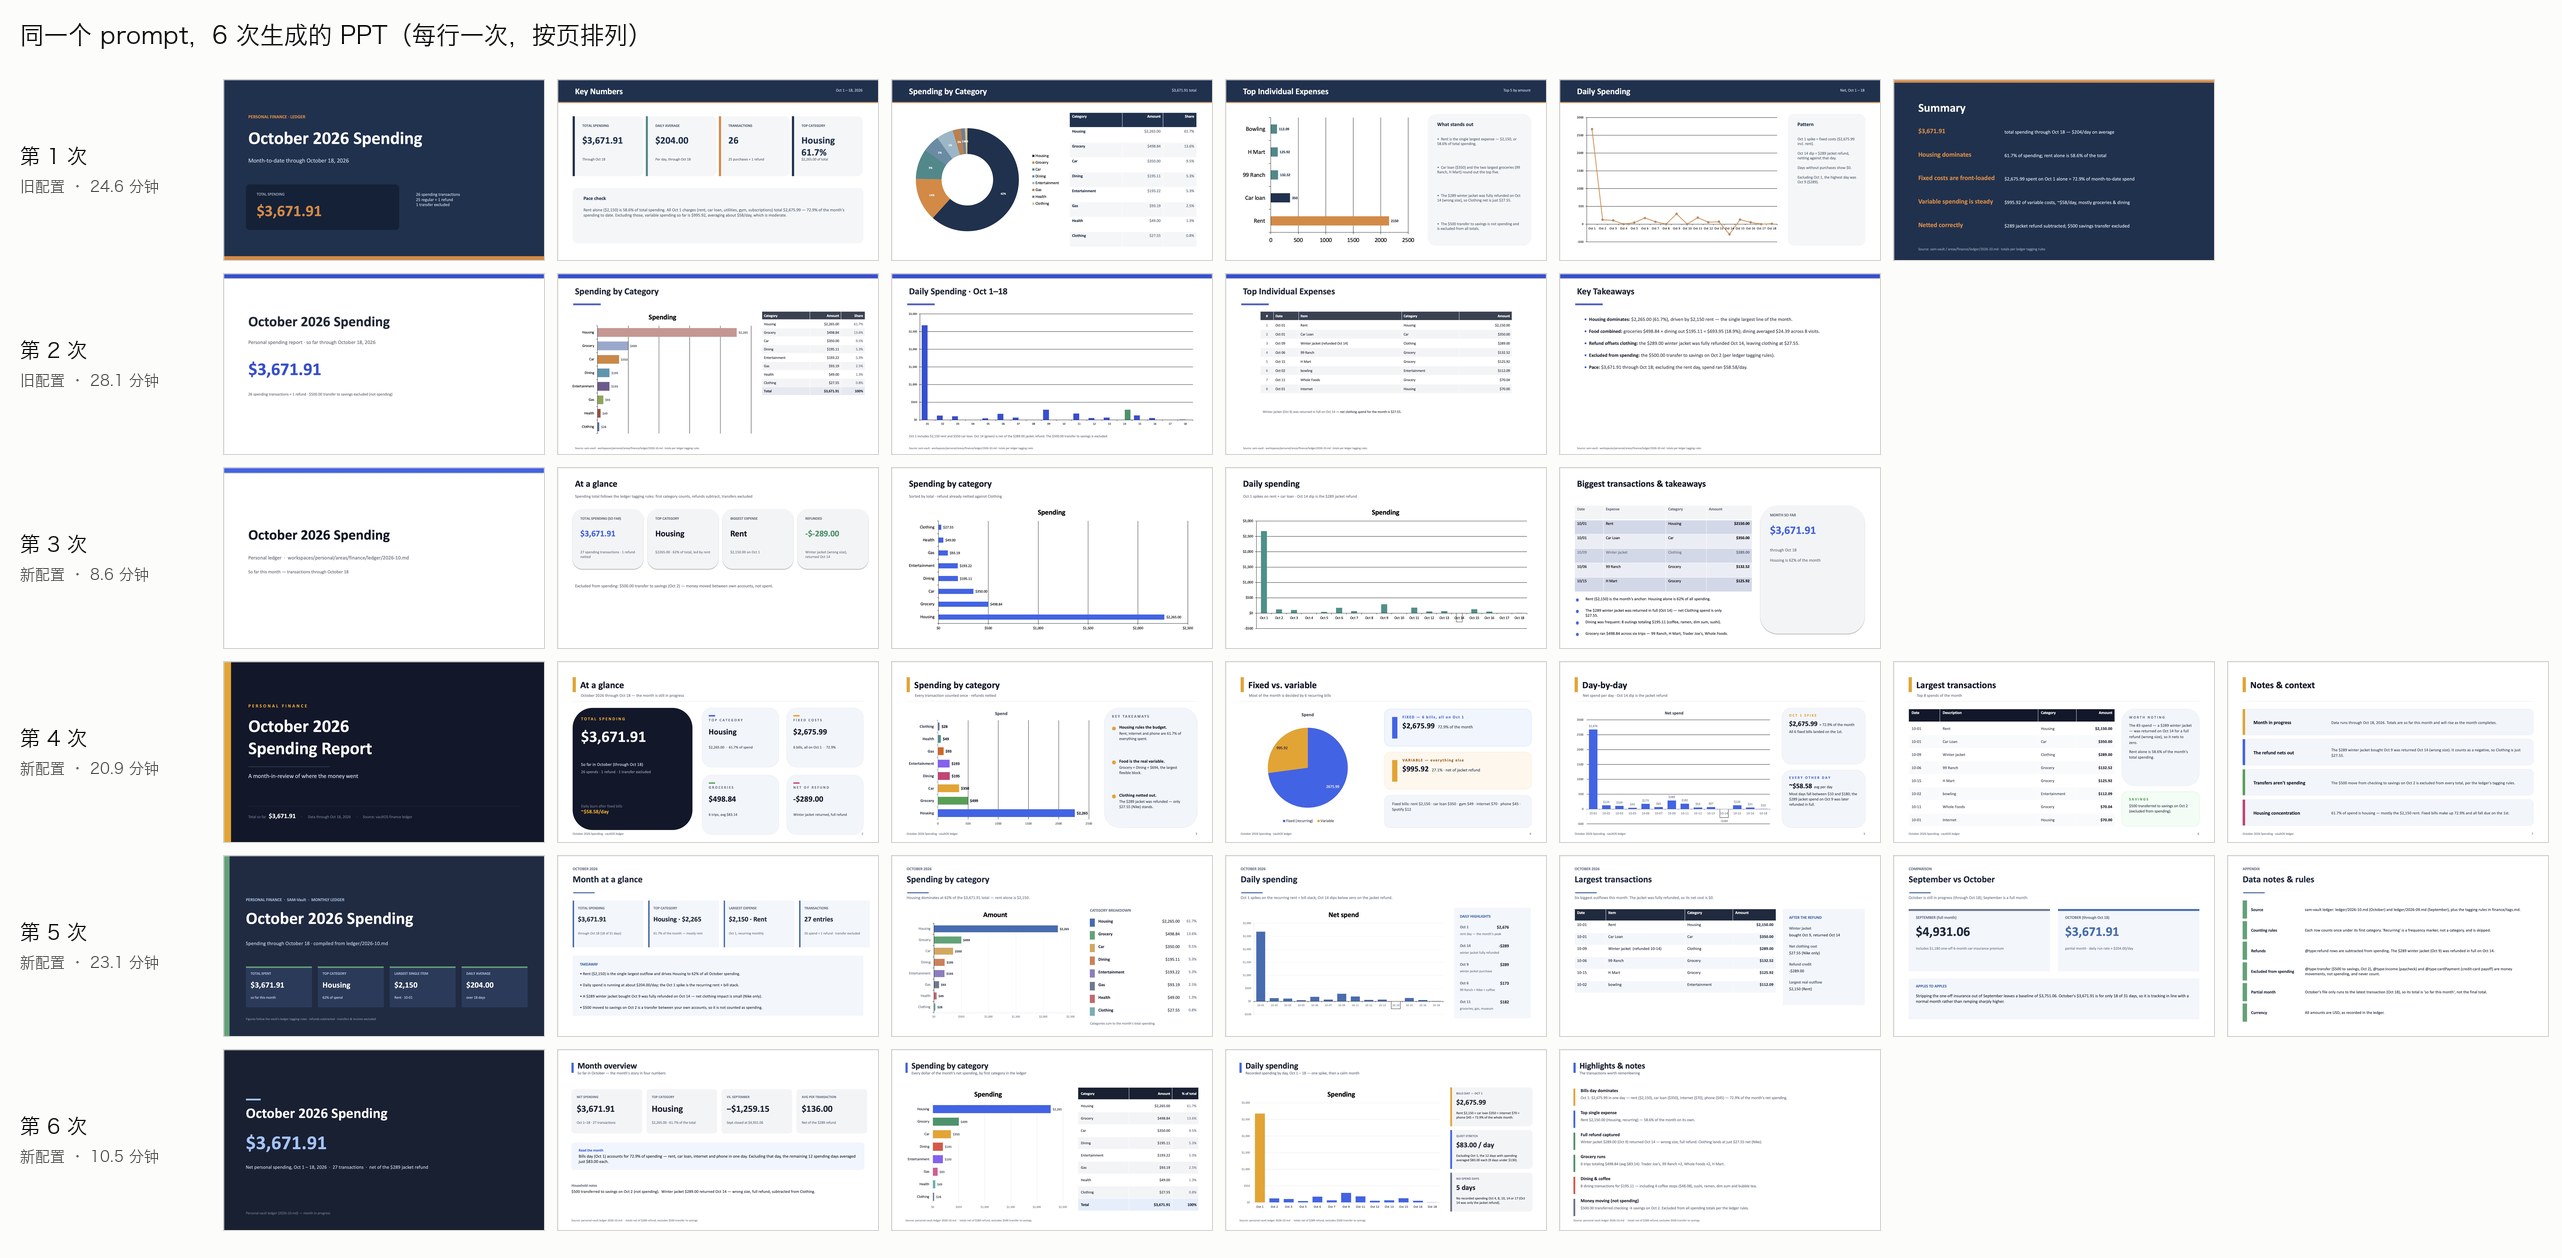
每一行是一次的全部页面。6 份没有一份是一样的,但有几个共同点:
- 每份都有完整的视觉体系。统一的配色和字号层级,封面、内容页、总结页分得很清楚。
- 图表都是 PowerPoint 原生图表,不是贴的图片,打开就能改数据。环形图、条形图、柱状图、饼图、折线图都用到了。
- 大数字卡片几乎每份都有:总额、最大分类、最大单笔、日均。
- 标题直接写结论,比如「Housing dominates at 62% of the $3,671.91 total」「one spike, then a calm month」。
- 会主动加细节。那件退掉的外套,第 3 次在表格里把那一行变灰,第 2、5 次在名字后面标了 refunded。第 5 次还加了一页附录,把记账规则逐条列出来。
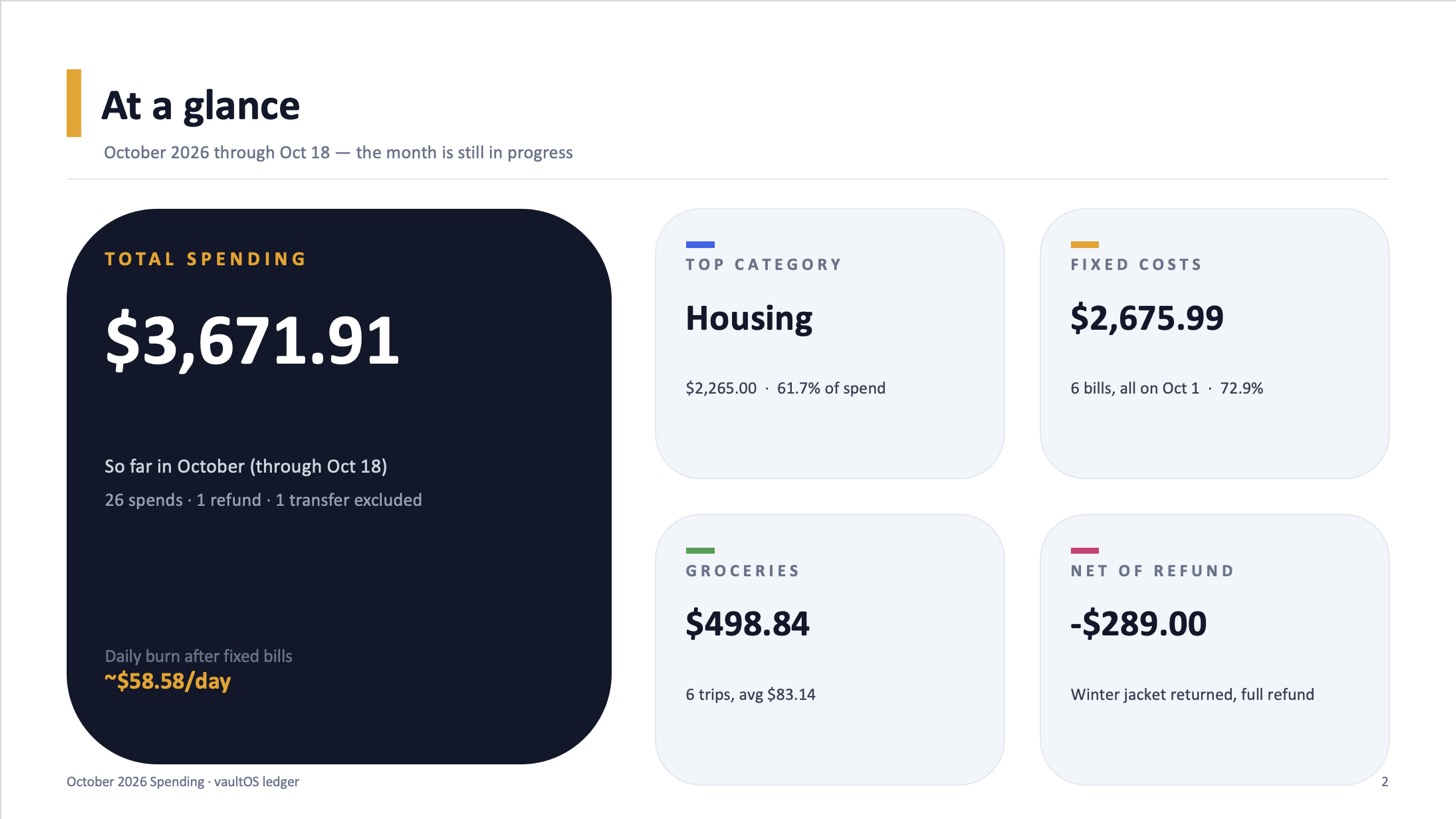
第 4 次是我最喜欢的一份:深色主卡片配四张小卡片,颜色、留白、层级都到位。
最让我意外的是:它其实看不见自己做的 PPT。这个模型在 harness 里只接受文字输入,所有排版都是用 python-pptx 在代码里「盲写」的,写完也只能用代码检查数据有没有填对。
也有不够好的地方。第 1 次的每日折线图被 10/1 的 $2,676 撑满纵轴,其余日子压成贴底的一条线;第 2 次把 10/14 的退款画成一根向上的绿柱,乍一看像那天花了钱;好几份在图表上方多放了一个没用的标题;卡片左边的色条、标题下的短横线,有点 AI 生成的味道。这些都是看一眼就能发现、改起来也快的问题。
数字靠谱吗?
| 次 | 事实错误 | 误导性说法 | 格式 / 来源 |
|---|---|---|---|
| 1 | 1 | 3 | 1 |
| 2 | 0 | 0 | 0 |
| 3 | 0 | 0 | 2 |
| 4 | 0 | 0 | 1 |
| 5 | 0 | 1 | 0 |
| 6 | 2 | 1 | 0 |
核心数字 6 次全对。总额 $3,671.91、8 个分类的金额和占比、每一天的数字都对;退款都抵扣了,转账都排除了,也都写明了「截至 10/18」。
这和第二期看到的一样。翻执行记录,6 次都是先自己找到并读了 tags.md,再让 Python 脚本从账本算数;做完之后,6 次也都重新打开 PPT 核对了里面的数据。第 1 次还在核对时抓到了自己的一个 bug:柱状图里填的是分类名,不是金额。
错都出在推论上,而且每次错的地方不一样:
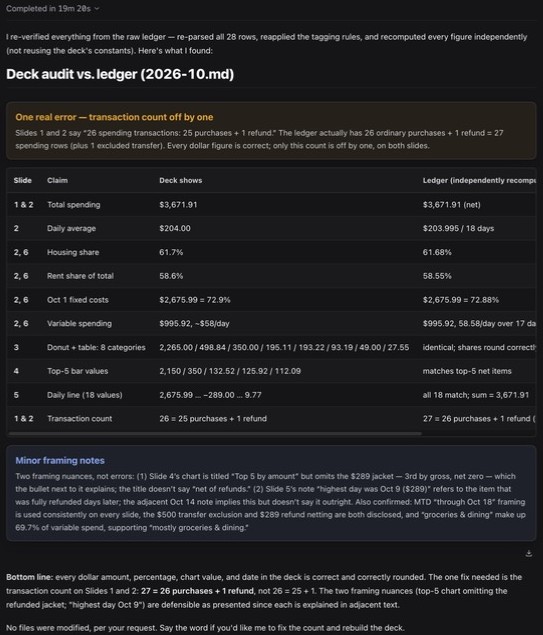
- 第 1 次把笔数写成「26 = 25 笔消费 + 1 笔退款」,实际是 26 笔消费加 1 笔退款。
- 第 1 次说「除了 10/1,花得最多的是 10/9($289)」,那 $289 正是后来全额退掉的外套。
- 第 6 次写「房租 + 车贷 + 网费 + 话费 = 72.9%」,漏了健身和 Spotify,这四项加起来只有 $2,615。
- 第 5、6 次都自己加了「9 月 vs 10 月」,拿 10 月前 18 天去比 9 月整个月。第 5 次还标着「APPLES TO APPLES」,结论是「和正常月份持平」。同期比(1 到 18 号,扣掉 9 月那笔一次性的车险),10 月其实高了大约 8%。
我还在第 1 次的对话里追问:「每个数字都对吗?有没有误导?」它花了 19 分钟,找到了笔数的错;另外两处误导它注意到了,但判断为「说得过去」。有意思的是,它是重新写了脚本、看到 purchases: 26 和 refunds: 1 分开打印之后才发现的。只是重读幻灯片的时候,它又给那个错的笔数打了一次勾。
慢在哪:一个 harness 设置
第 1 次花了 24 分 36 秒。翻执行记录,有将近三成时间根本没在干活,而是在压缩上下文:上下文才到 3 万出头,harness 就几乎每一步都压缩一次,20 次里 11 次还失败了。更隐蔽的是,每次压缩会改写对话开头,下一步的缓存就失效了,得把两万多 token 重新读一遍,这样的一步要一到三分钟。
原因是上一期留下的设置。我把 harness 的上下文设成 131,072、输出 32,768,以为上限对齐就够了。但 harness 的压缩还会再留出 65,536 的余量,触发点就只剩 131,072 − 32,768 − 65,536 = 32,768。
这个余量写在 Standard 预设里面,直接改压缩插件的配置不会生效(我改过一次,白跑了 28 分钟)。能改的是模型的上下文窗口:我把 Qwen 的上下文从 131,072 调到 172,032,触发点就变成 73,728,做这种 PPT 根本碰不到。172,032 + 32,768 正好等于 oMLX 的 204,800,没破上一期定的规则。
| oMLX 上下文 / 输出 | harness 上下文 / 输出 | 压缩触发点 | |
|---|---|---|---|
| 上一期 | 204,800 / 32,768 | 131,072 / 32,768 | 32,768 |
| 现在 | 204,800 / 32,768 | 172,032 / 32,768 | 73,728 |
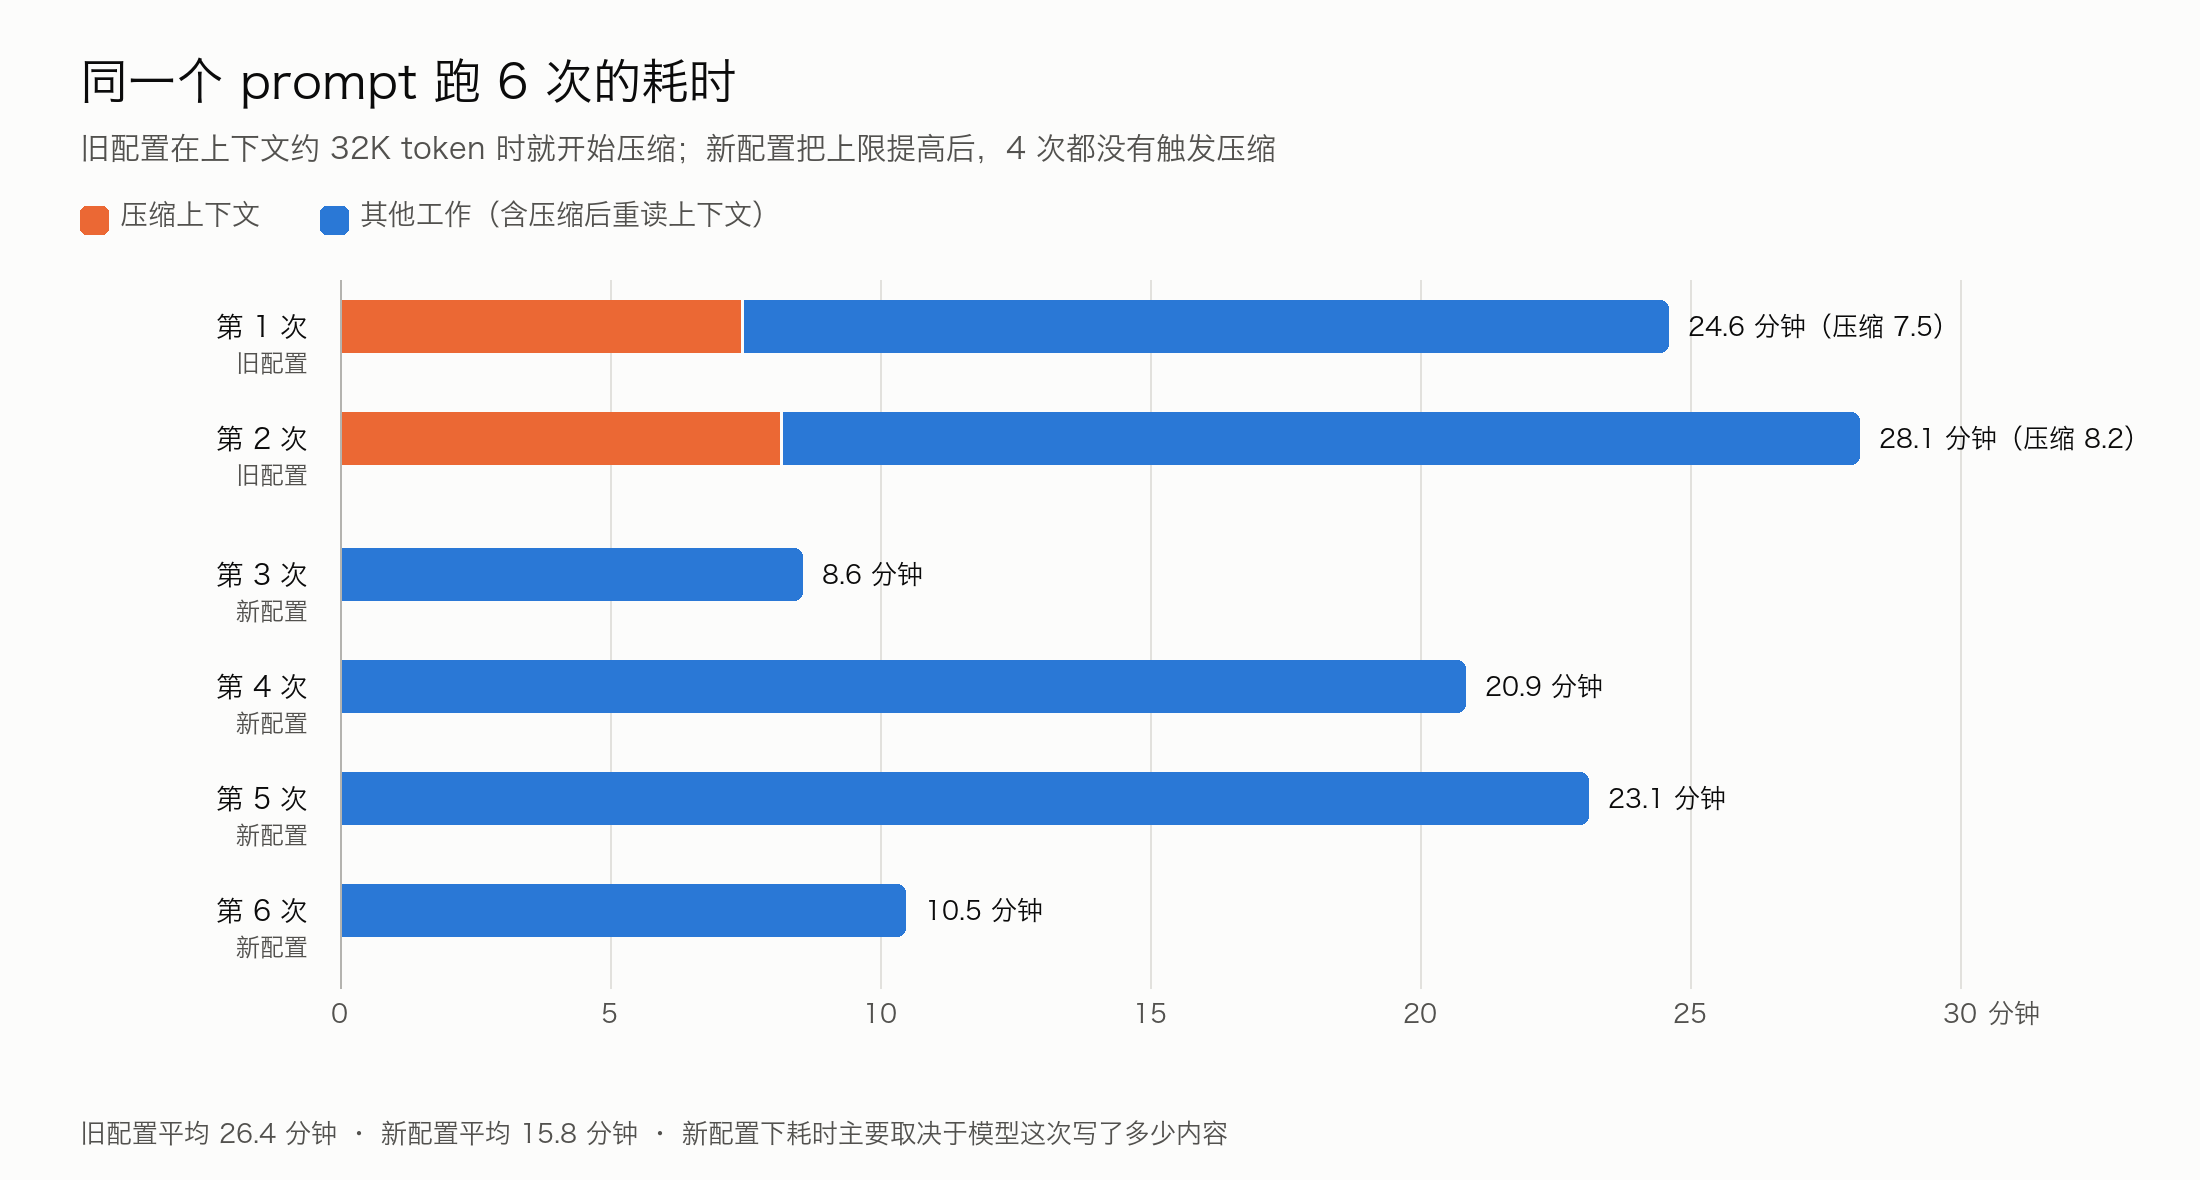
改完之后的 4 次都没有触发压缩。平均耗时从 26.4 分钟降到 15.8 分钟;按每生成一千个 token 算,从 1.21 分钟降到 0.64 分钟,大约快了一倍。准确度没有变差:两种配置下,平均每次都是 0.5 个事实错误。新配置下单次 8.6 到 23.1 分钟不等,主要看模型这次决定写多少:5 到 7 页,加不加 9 月对比。
我的结论
- 设计是真的惊喜。一句话的 prompt,本地 27B 能稳定做出有完整视觉体系、原生图表、带结论标题的 PPT。
- 核心数字可以信。它会自己找规则、用代码算、回头核对,6 次的总额、分类和每日数据全对。
- 推论要人看。平均数的口径、跨月对比、明细拆分,这些地方每次都可能出错,而且错法不固定。
- 建议的用法:让它交付时附一份「每个数字从哪来」的对照表;要它自查时,明确说「用脚本重算一遍」,不要只说「检查一下」;版面自己扫一眼。
- 检查一下 harness 的压缩触发点。这次只改了一个数,平均就快了 40%。
局限
旧配置只跑了 2 次,新配置跑了 4 次,次数都不多。打分只看文字,版面没有计分。评分清单是我自己定的,数据是按我自己格式造的假数据,10 月只有 28 行。我没有用云端模型跑同一个 prompt 做对照,「有 Opus 4.6 的感觉」只是我的印象。数据只来自一台机器。
写在最后
做完这次实验,我其实慢慢觉得本地模型可以干一些实用的活了。接下来我会陆续做更多测试,比如让它创建、修改 PDF 之类的实验,敬请期待。