我把生活记在一堆普通的 Markdown 文件里:每月一份账本,一份持仓笔记,一份睡眠和训练记录,一张项目清单。我想知道,关于这些文件的问题,哪些可以交给一台跑在我自己 Mac 上的模型。我不关心排行榜上的分数,只关心一件事:我问「这个月钱都花在哪了?」,回来的答案能不能信。
所以我开了一个系列:本地模型实测(Local Model Lab)。每一期都问同样的七个问题,每个问题代表一种不同的任务,问的是同一个虚构人物的笔记,每个数字都对照标准答案逐项核对。每一期只换一个变量:模型、给它的工具,或者它的设置。这样期与期之间可以直接比较,新模型出来了,也能拿同一套题去跑。
这第一期是基线:只测一个模型 Ornith 1.5 35B,只有一条规矩:每个回答都必须变成一个我能核对的界面,要有图表、表格和数字,而不是一段话。
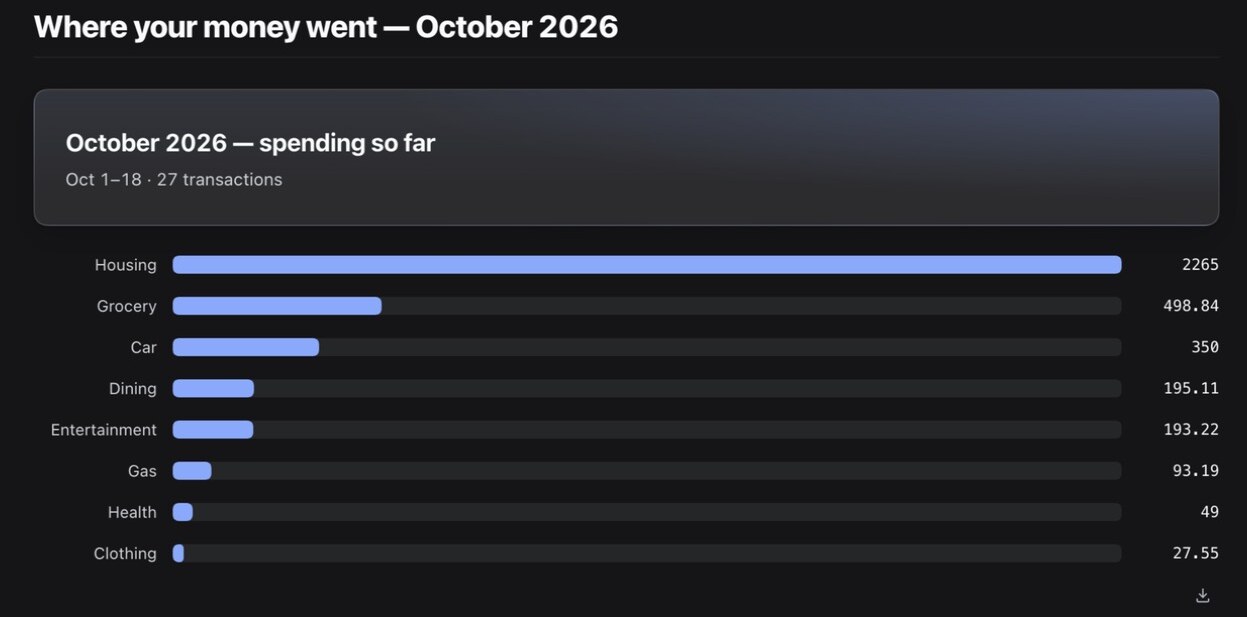
先说结论:本地模型很会读,会照着写好的规则办事,也会挑合适的图表;但它不擅长对很多行数据做加法。上面这张图完全正确,后面那张趋势图就不是了。
实验设置
- 机器:一台 48GB 内存的 Apple Silicon Mac,所有东西都不离开这台机器。
- 模型:Ornith 1.5 35B-A3B(4-bit)。它是混合专家(MoE)模型,总共 35B 参数,每个 token 只激活约 3B,所以在笔记本上也跑得快。思考(thinking)开着。
- Harness:DeepSeek Harness 0.2.1-rc.2,一个桌面端的 agent 应用,通过 oMLX 0.7 接到本地模型。
- 界面部分:dsh-genui 0.13.0,一个第三方插件,让模型用统计卡、表格和图表回答,而不只是文字。安装前我读过它的源码,它不会往外发任何数据。
这些笔记属于 Sam Lin,一个不存在的人。一个脚本按我自己用的文件格式,生成了他一整年的生活:每月大约 28 笔账,十个持仓,两个月的健康记录,六个项目。数据是脚本写的,所以正确答案也由脚本算出,并且放在模型看不到的文件夹外面。我还埋了几个坑:一笔 500 美元转进储蓄账户的钱(不算支出);一件买了又全额退款的外套;工资和还信用卡的记录,如果直接加总会让每月数字翻倍;还有项目清单里一段过时的旧记录。
每个问题都在新会话里只问一次,agent 设为只读模式。我没有加「请画个图」,要不要出界面,由模型自己决定。
七个问题,七种任务
| 任务类型 | 问题 | 耗时 | 结果 |
|---|---|---|---|
| 按写好的规则处理一个月的账 | 这个月钱都花在哪了? | 1 分 20 秒 | ✓ 8 个类别全对,转账排除,退款抵消 |
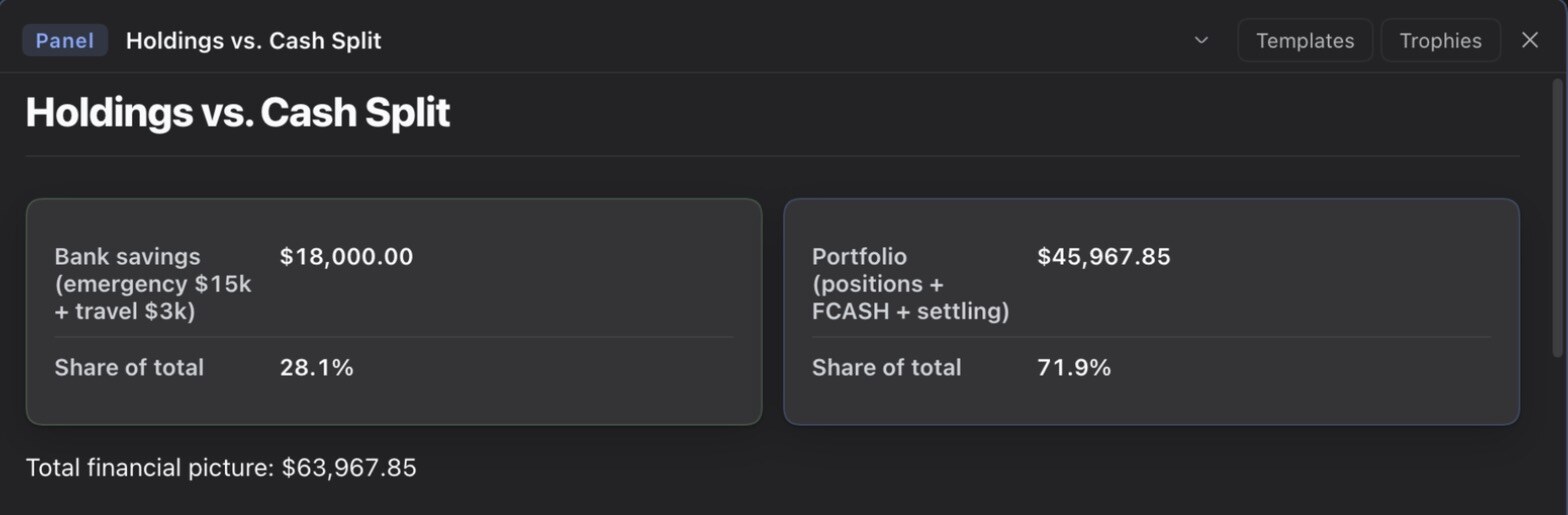
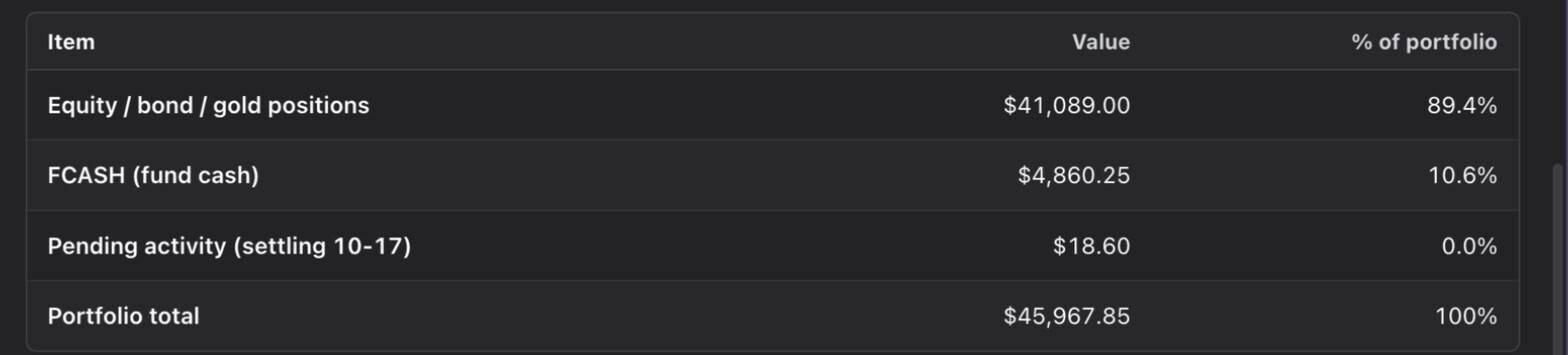
| 从原始数据推算 | 我现在的持仓和现金怎么分布? | 1 分 40 秒 | ✓ 10 个持仓按股数 × 价格算出,和券商总额分毫不差 |
| 只看最新状态,忽略过时记录 | 我现在在推进哪些项目? | 42 秒 | ✓ 3 个进行中,已暂停的那个被正确排除 |
| 按日志自己的约定做总结 | 这个月睡得怎么样,练了几次? | 2 分 24 秒 | ✓ 数字全对 · ✗ 界面没渲染出来 |
| 常识问答变成图表 | 对比 V60、法压壶、爱乐压 | 26 秒 | ✓ 图表和表格一致 · 一处常识错误 |
| 做一个能交互的小工具 | 帮我做一个复利计算器 | 2 分 55 秒 | ✓ 计算正确 · ⚠ 滑块调一次要等 1 分 22 秒 |
| 汇总一整年的账 | 最近开销是越来越多还是越来越少? | 跑了 3 次 | ✗ 先是死循环,再是 6 个月对 4 个,最后编数字 |
七个里有六个能用。第七个才是最有意思的。
它真正做得好的地方
「钱花在哪」这道题比看起来难。如果直接把账本一行行加起来,会把那笔 500 美元的储蓄转账当成支出,退款的外套也会被算两次。模型先去读了标签规则文件,排除了转账,把退款抵消为零,还用大白话解释了为什么这样算。8 个类别和标准答案完全一致。
持仓笔记里只记了股数和最新价,所以每一笔市值都得现算。模型把十个都算了,加上券商账户里的现金和一笔待结算款,还注意到自己算出的总额和券商显示的一分不差。它还把银行储蓄单独放成一张卡,没有和券商账户里的现金混在一起。很多人都会把这两样搞混。
项目那道题也有坑:在「当前状态」表下面,有一段旧的「Active」记录,里面还列着一个后来已经暂停的项目。模型只认那张状态表,把暂停的项目排除掉,还注明了它读的是哪个文件。用时 42 秒。
它崩在哪:一整年的算术
「开销是越来越多还是越来越少?」意味着要跨十二个月度文件、把大约 300 行加起来,同时还要守住前面那些规则。我问了三次。
第一次:它开始在思考里逐笔列出 10 月的交易,加完觉得总数对不上,又从头再列一遍。四分钟后它还在反复数 10 月,而 10 月和「趋势」根本没关系。我把它停掉了。
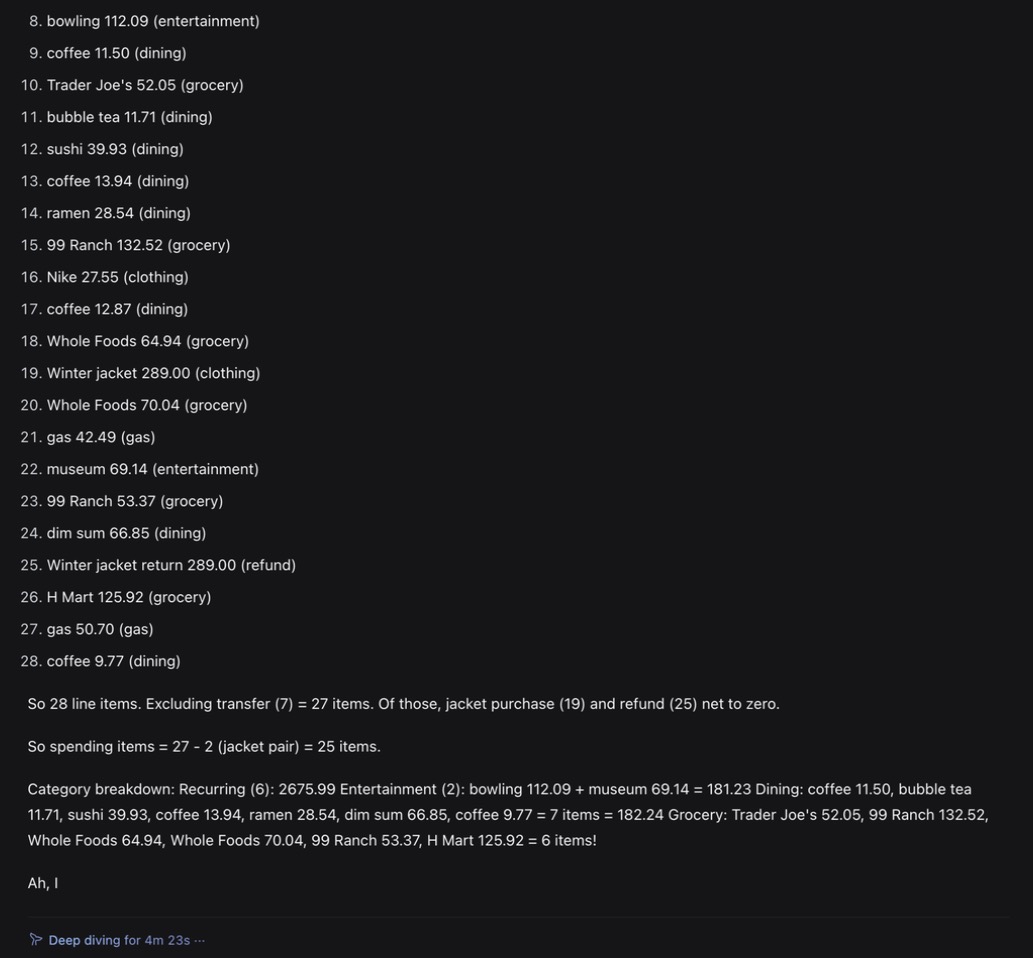
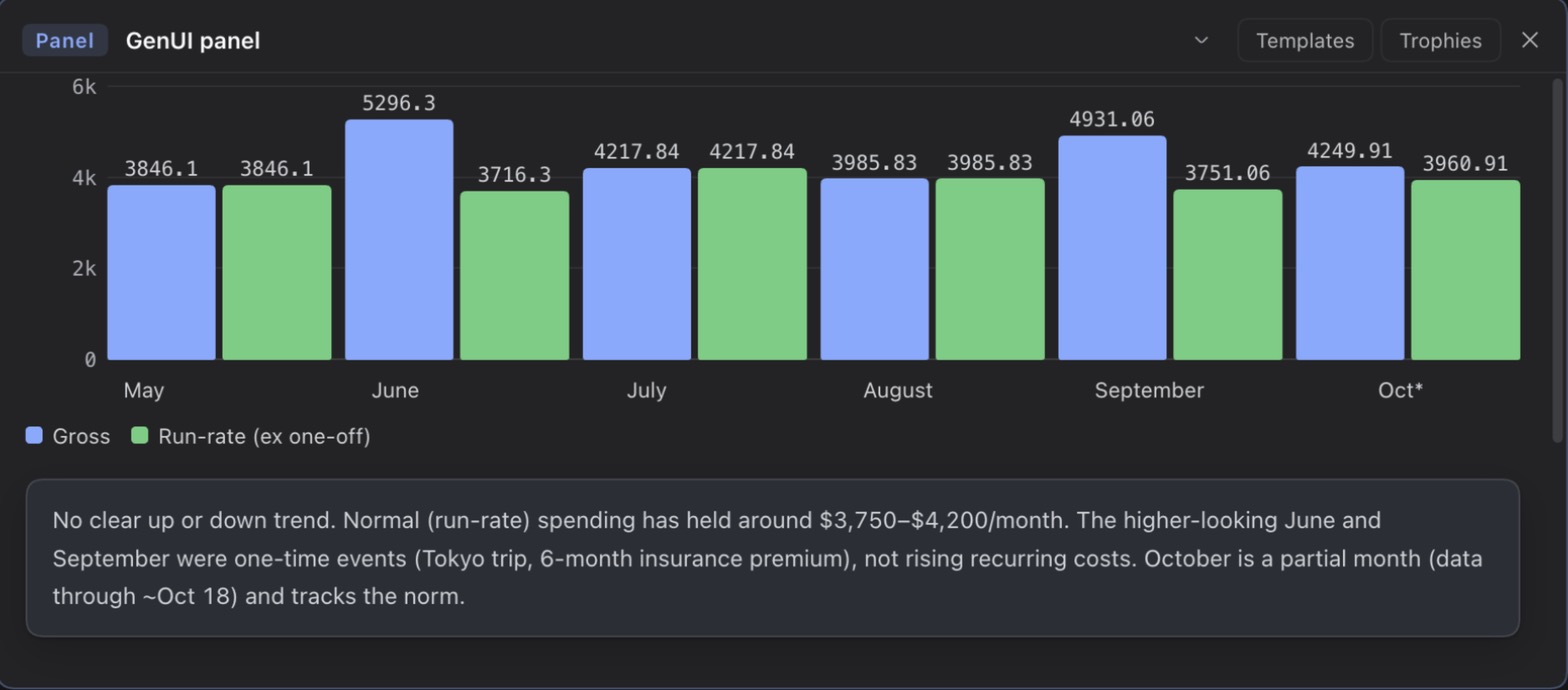
第二次:3 分 46 秒跑完,给出一张很像样的图:把总开销和去掉一次性支出(比如一次东京旅行)后的「日常开销」分开对比。结论「没有明显趋势,6 月和 9 月是一次性支出」是对的。但六个月的合计里只有四个对:7 月少了 28.61 美元;10 月多了 578 美元,正好是那件退款外套被加了两次,而它的回答里明明写着「已经抵消了退款」。
第三次,关掉思考:33 秒。每个月的合计都是带波浪号的约数,十个月一个都没对。2 月算出「约 1,840 美元」,比它上一行自己算出的每月固定开销 2,676 美元还少。
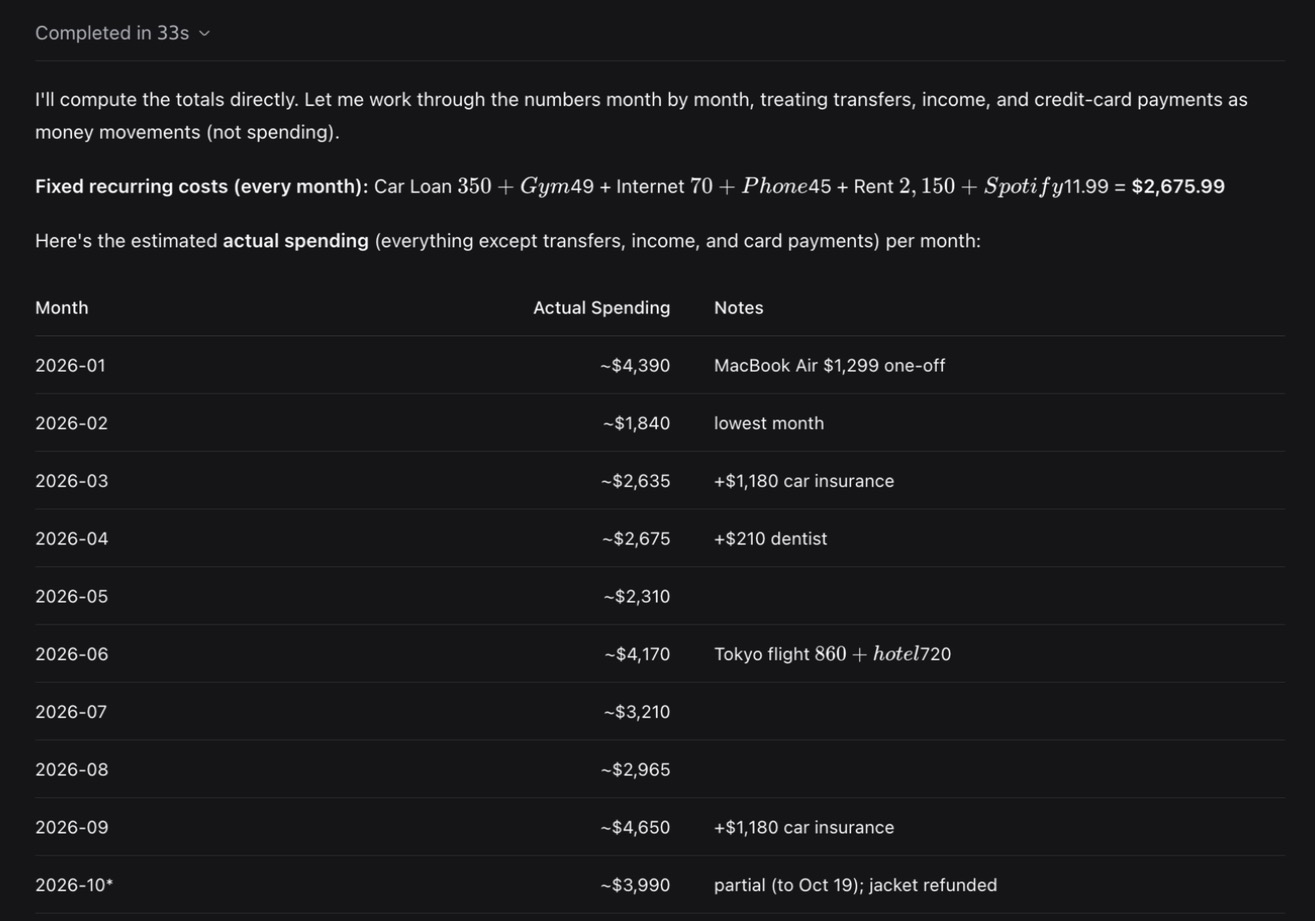
这三次差不多就是这一期最主要的收获。开着思考,模型慢,大体算得对,但可能卡住;关掉思考,它快,却会理直气壮地算错。两种都不该拿来汇总我一整年的账。不过这其实不是语言能力的问题:十行代码就能把这些合计算得分毫不差,每次都对,只要几毫秒。
三个没想到的地方
「只读」不等于「只看这个文件夹」。第一次问项目那道题时,agent 没理会笔记文件夹,直接跑去列我真实的代码目录。它认定「我的项目」指的是代码。这个 harness 的只读模式拦得住写,拦不住读。因为模型在本地,什么都没有离开这台机器。我作废了那一次,把测试用的笔记挪到一个隔离的文件夹,重新问了一遍。但如果你让 agent 处理个人文件,那个文件夹周围的东西,它也都看得到。
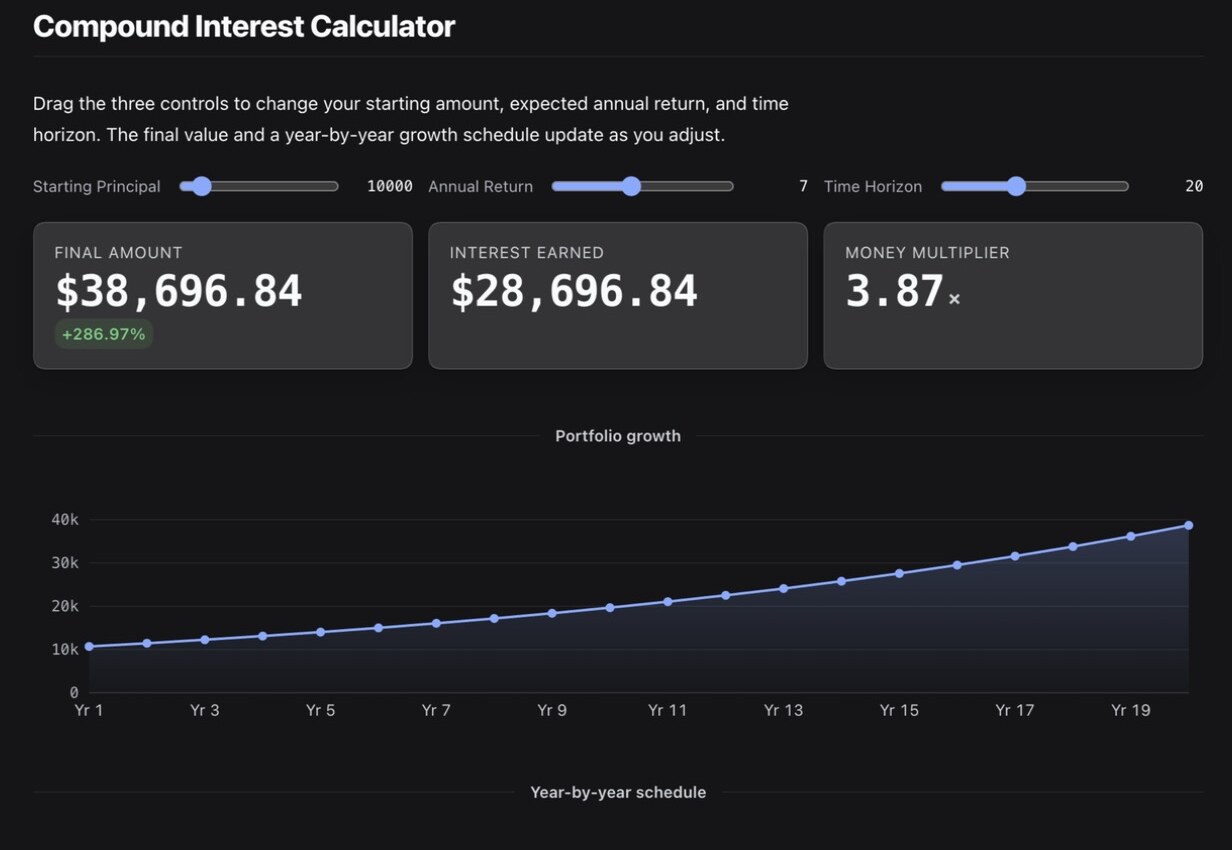
「能交互」可能意味着「再问一遍模型」。复利计算器有真的滑块,数字也对:1 万美元、年化 7%、20 年,结果是 38,696.84 美元。可我拖动利率滑块以后,界面 1 分 22 秒没有任何变化,然后才冒出一个全新的计算器,答案也是对的。这个插件会把每一次交互都发回给模型,所以在本地模型上,每拖一下都要等一分多钟,而模型自己写的说明里却说图表会「立刻」更新。
写出合格的界面,本身就是一项单独的能力。健康那道题的数字全对:记录了 16 晚,平均睡 7.1 小时,练了 7 次。那些 10 分钟的兜底训练也算进去了,空着没记录的日子也没有被当成休息日。但它写的界面 JSON 一直通不过插件的校验,最后只好放弃界面,改用纯文字回答。这个插件还会把两个美元金额之间的文字当成数学公式来渲染,有时候还会把图表塞进一个默认折叠的侧边面板。这些都是一个年轻插件的毛病,本文所有的图表也都是它渲染出来的,但在一个慢模型上,这些毛病都要实打实地花时间。
现在我会交给本地模型的事
- 可以交:读一篇笔记并总结,按写好的规则处理几行数据,把一张小表格变成图表,回答常识类的问题。
- 还不行:任何要跨很多行求和的事,任何「差不多对」就会出问题的事(主要是钱),以及在一个旁边放着它不该看的东西的文件夹里随意翻找。
解决第二类问题,靠的不是更聪明的模型。让模型负责读和判断,让代码负责算。
这个系列接下来
- #2:给它工具。同一个模型、同一套题,但给它几个小小的计算工具(「按月汇总」「持仓市值」),并且在 token 层面把界面输出约束成固定格式(oMLX 已经支持)。如果我想得没错,趋势那道题会从「崩溃」变成「平平无奇」。
- #3:按类型比较模型。混合专家模型对比稠密模型,12B 对比 27B 和 35B,4-bit 对比 6-bit,开思考对比关思考。每道题跑三次,汇总成一张持续更新的总表。先透露一个只跑过一次的早期迹象:同一道咖啡题,一个 27B 的稠密模型用了 13 分钟,Ornith 只用了一分半左右。
老实说,这一期有几处局限:每题只跑了一次(趋势那题跑了三次),只测了一个模型,题目是我自己出的,数据是按我自己格式造的假数据。这一期展示的是 Ornith 能做到什么,而不是它能稳定做到什么。重复测量从 #3 开始。生成数据的脚本、标准答案和运行记录都可以复现,所以之后的每一期,都会用完全相同的七个问题来衡量。