上一期结尾我写:「解决办法不是更聪明的模型。让模型负责读和判断,让代码负责算。」我原本打算第二期就照这个思路,给 Ornith 加几个算数工具。
后来我改了主意。工具是我替模型补的短板,而我更想知道本地模型自己能走多远:如果哪天某个本地模型聪明到不需要这些工具,我想第一时间看到。所以这一期把原计划的第三期提前:一个工具都不加,只换模型。
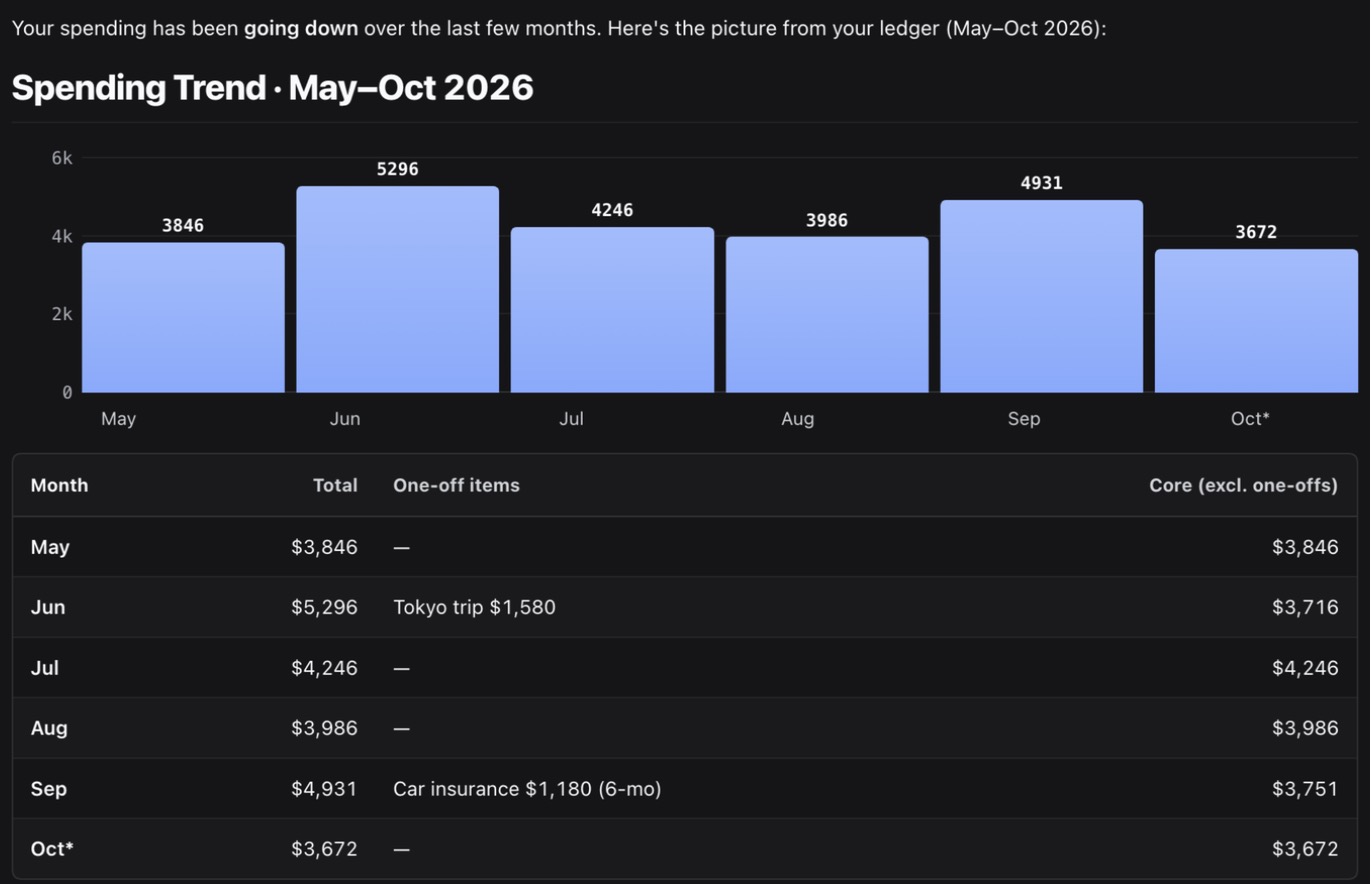
结果有点讽刺:更大的模型同样不会心算,但它自己想到了让代码来算。
实验设置
- 环境不变:同一台 48GB 内存的 Apple Silicon Mac,同一个 DeepSeek Harness 0.2.1-rc.2,同一个 dsh-genui 插件,oMLX 升到了 0.7.2。所有东西都不离开这台机器。
- 数据不变:还是虚构人物 Sam Lin 的笔记,坑也一样:一笔转进储蓄的钱、一件买了又退的外套、会让合计翻倍的工资和还卡记录。
- 只问出过问题的那类题:「这个月钱都花在哪了?」(一个月 27 笔)和「最近几个月开销是越来越多还是越来越少?」(十二个月约 300 笔)。另外五题上一期已经能用,这次不重复。
- 规矩不变:每题一个新会话,只读模式,思考开到最高,问题原文照抄。我没提示「用代码」,也没加任何工具:模型只有 harness 自带的读文件、搜索和终端。
参赛的三个模型:
- Ornith 1.5 35B-A3B:上一期的主角。混合专家(MoE)模型,每个 token 只激活约 3B 参数,所以快。
- Qwen3.8 27B:稠密模型,每个 token 都要动用全部 27B 参数,慢得多。4-bit,开着 MTP 推测解码加速(下一期细说)。
- LFM2.5 24B-A2B:一个新的小激活 MoE 模型,主打调用工具。先单独跑了一轮淘汰赛。
结果
| 模型 | 一个月的账 | 一整年的趋势 |
|---|---|---|
| Ornith 35B-A3B | ✓ 2 分 26 秒 | ✗ 1 分 19 秒:给了 4 个月,9 月少算 41 美元 |
| Qwen3.8 27B | ✓ 5 分 22 秒 | ✓ 11 分 24 秒:5 到 10 月六个月全对 ✗ 第二次:算对了,但没说出来 第三次作废(见后文) |
| LFM2.5 24B-A2B | ✗ 三次都错 | ✗ 给了 9 个月,错 7 个 |
差别不在谁更会算。我翻了每一次的执行记录:Ornith 一次代码都没写,所有加法都在脑子里做;Qwen 每一次都在终端里写一小段 Python,解析账本、按月加总。没有人叫它这么做。
最值得看的一刻
Qwen 回答趋势题的那一次,先在思考里把 9 月的账手算了一遍,得到 4,753.95 美元;接着写脚本又算了一遍,得到 4,931.06 美元。两个数对不上。
"The script's September total ($4,931.06) differs from my hand sum ($4,753.95) — let me debug which rows it's counting."
(脚本算出的 9 月总额和我手算的不一样,我去查查它数了哪几行。)
它把两边逐行对了一遍,找到了原因:
"Found it — my hand sum had missed two September rows (Trader Joe's $44.29 + Whole Foods $132.82 = $177.11). The script is correct."
(找到了:我手算漏了 9 月的两行。脚本是对的。)
4,931.06 − 4,753.95 正好是 177.11。它手算出错的方式和上一期的 Ornith 一模一样:几百行里漏掉几行。不同的是,它知道自己可能算错,所以用代码复核,并且在两个结果冲突时选择相信代码。
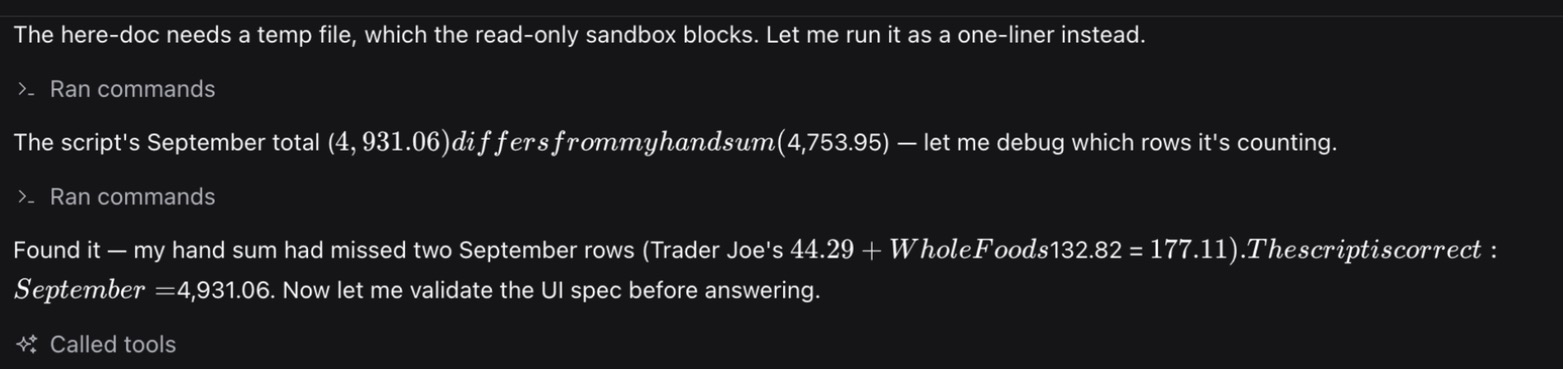
截图里那几段斜体,是插件把两个美元符号之间的文字当成了数学公式,上一期提过的老毛病。
上一期我说该让代码负责算,我以为那得由我来搭。结果 27B 自己就这么做了。
Ornith:又快又错
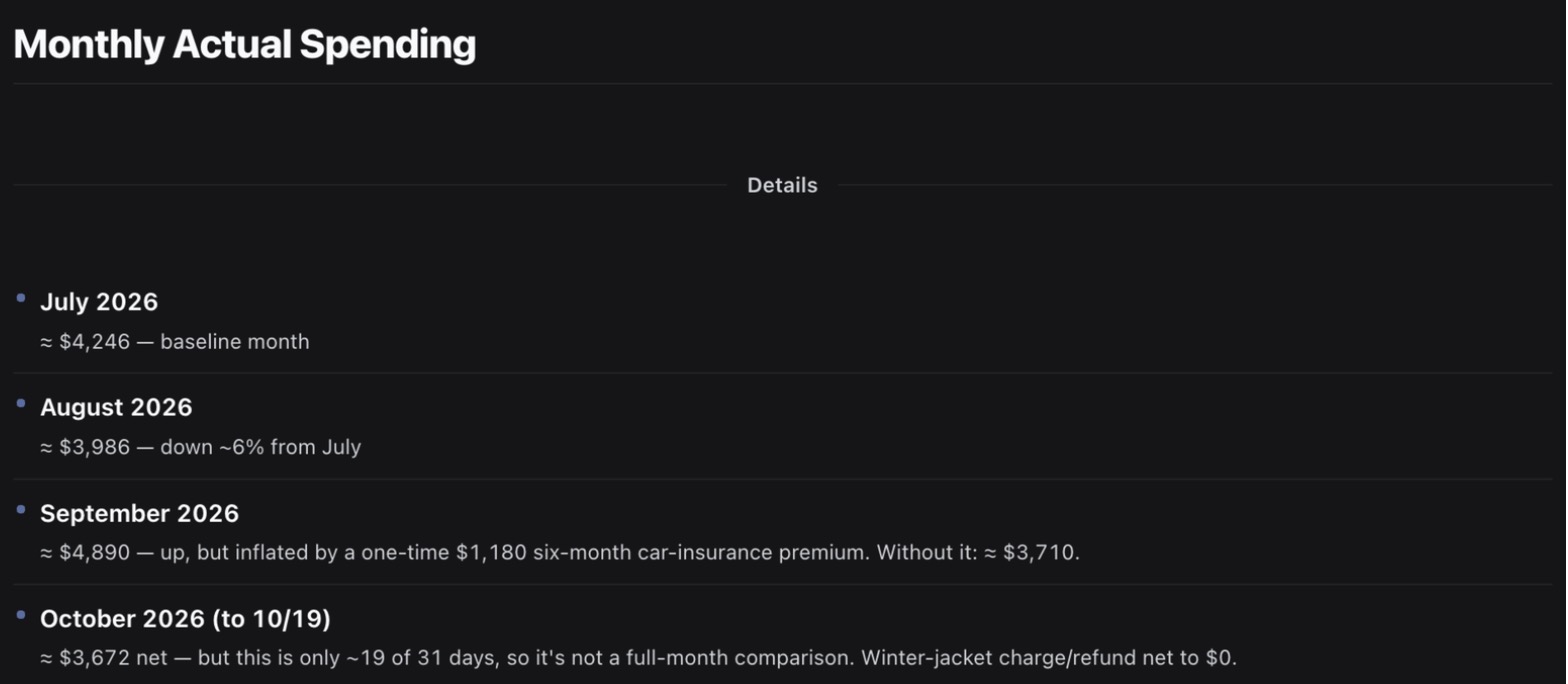
Ornith 只用 1 分 19 秒就答完了趋势题,结论「基本持平、略有下降」也说得过去。它本来写了一张柱状图,但图没渲染出来,只剩下面这张每月明细。注意每个数字前面的「≈」:它自己也知道这些是估的。四个月里有三个其实分毫不差,9 月写成 4,890 美元,实际是 4,931.06。加上上一期的三次,这道题 Ornith 一共答了四次,没有一次全对。
Qwen 也会失败
算对了,却没说出来。第二次问趋势题,Qwen 同样写了脚本,十二个月的合计在它的思考里全都是对的。可它在动笔写最终回答之前想得太久,撞上了 harness 给每一步设的 16,384 token 输出上限,这一轮就此结束,我看到的是一个没有答案的回复。这不是模型算错,是我的设置太小。我已经把上限调到 32,768,下一期细说。
慢。同样的题,Qwen 用的时间是 Ornith 的 2 到 9 倍:一个月的账 5 分多钟,一整年 11 分多钟。它值得等,前提是你不急。
另外,它对趋势的判断是「在下降」,而我出题时的口径是「没有明显趋势」。数字全对,判断见仁见智,我只按数字打分。
LFM2.5:淘汰
LFM2.5 主打调用工具,可在这个 harness 里,它连调用的格式都对不上:它把整组参数塞进一个字符串,harness 一直报「缺少必填参数」,有一次同一个错误连犯 58 次,直到十分钟超时。读表也出错:健康记录里有一列起床时间,它把「08:33」当成睡了 8.33 个小时。查项目、看持仓这类题它答得又快又对,可一涉及计算或读表就不行了。我没再继续测它。
一道开放题:30 多个数字,错了 1 个
最后我换了个问法,不出题,只说:「看看这个文件夹,告诉我你都知道些什么。」用的是同一个 Qwen 27B 的另一个版本(模型文件自带 MTP 层,下一期细说),思考只开到 Low 档。
它把整个文件夹翻了一遍,写了一份涵盖财务、健康和项目的总结:净资产,券商账户,十个持仓的市值、占比和收益,这个月的开销,两个月的睡眠和训练,六个项目的状态。我逐项核对了 30 多个数字,只错了一个:9 月的训练次数写成 12,实际是 13(10 分钟的兜底训练也算一次,它漏数了一次)。过程中它又说了一句:「我手算差了一点,脚本给出的 10 月总额是 3,671.91 美元。」
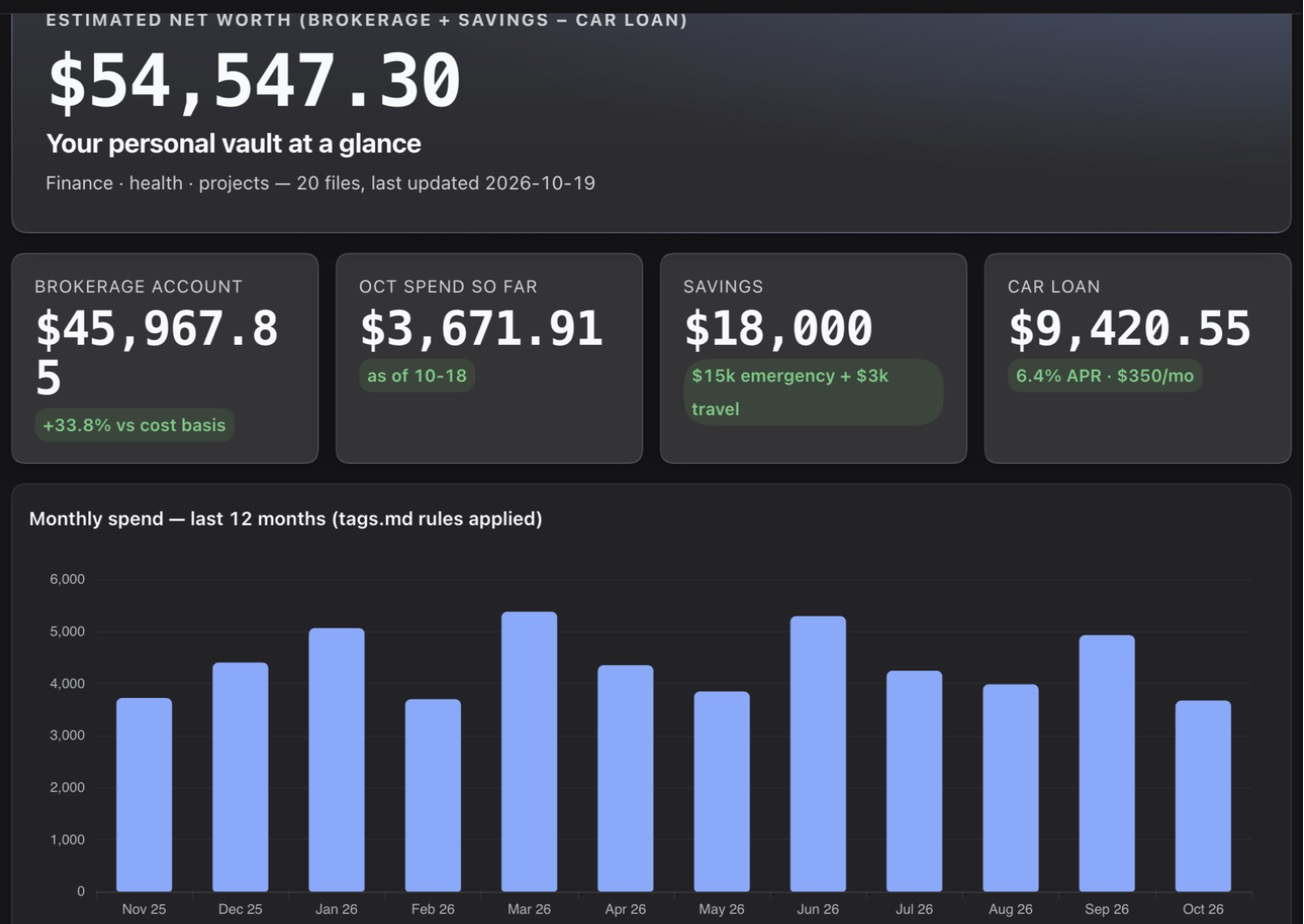
思考只开到 Low 档还能这么准,说明它的准确主要来自用代码复核,而不是想得久。代价依然是时间:这一轮用了 16 分钟,其中不少花在画界面上。
「只读」不等于「只能读这里」,第二次
上一期我写过,agent 的只读模式拦得住写、拦不住读:Ornith 曾经跑去翻我的代码目录。这一期又发生了一次,而且这次更值得警惕。
Qwen 第三次回答趋势题时,先正常读了测试文件夹,然后调用了 harness 的「技能」功能。我电脑上存着一些给其他 AI 工具写的技能说明,其中一份描述了我真实的笔记库,路径就写在里面。harness 会自动把这些技能交给模型。模型加载了那份技能,顺着路径读了我真实的账本,然后用我的真实数据回答了一个关于虚构人物的问题。
后果是有限的:模型在本地,数据没有离开这台电脑;只读模式拦住了写入,我的真实笔记一个字都没被改;那次结果我作废了,本文没有任何真实数据。但它暴露了一个容易被忽略的问题:你给 agent 的「工作文件夹」,并不是它能看到的全部。harness 的技能、记忆这类功能,可能会把模型引到你没打算给它看的地方。
现在我做测试时会关掉技能功能,并且每次都检查执行记录,看它有没有读工作文件夹以外的路径。
现在我会怎么分工
- Ornith:查东西、看现状、读一篇笔记做总结,几十秒就有结果。
- Qwen 27B:数字要准、数据又私密的事,比如真实的账。丢给它,去忙别的,十分钟后回来看。
- 两个都一样:结果还是要自己核对。
最后一条是这两期最大的收获。本地模型和其他 AI 没什么不同:会犯错,会过度自信,偶尔还会去读不该读的东西。区别只在于,好一点的模型会自己核对自己。
下一期
#3:怎么让 27B 在 48GB 的 Mac 上跑得快、跑得稳。两种 MTP 推测解码的区别,TurboQuant 换来的内存余量,以及那个让模型「算对了却说不出来」的输出上限。
局限照例说清楚:每题只跑了一到三次(Qwen 的趋势题有效的只有两次),只有两道算术题,数据是按我自己的格式造的假数据。Ornith 和 Qwen 的速度也不完全可比:Qwen 有推测解码加速,而 Ornith 没有可用的草稿模型。这一期展示的是它们能做到什么,而不是能稳定做到什么。